PredictorMeasurements
PredictorMeasurements[predictor,testset,prop]
当 predictor 对 testset 进行计算时,给出和属性 prop 相关联的测试.
PredictorMeasurements[predictor,testset]
生成可应用于任何属性的测量报告.
PredictorMeasurements[data,…]
使用预测 data 而非预测器.
PredictorMeasurements[…,{prop1,prop2,…}]
给出属性 prop1、prop2 等.
更多信息和选项
- 度量用于决定不用于训练(测试集)的数据的预测器的性能.
- 可能的度量包括分类指标(准确性、似然性等),可视化(混淆矩阵、接受者操作特性曲线等)或特定返利(如最糟分类范例).
- predictor 通常是由 Predict 生成的 PredictorFunction 对象.
- 在 PredictorMeasurements[data,…] 中,预测 data 可以有如下形式:
-
{y1,y2,…} 预测器做出的预测(人文、算法等.) {dist1,dist2,…} 预测器获得的预测性分布 - PredictorMeasurements[…,opts] 指明预测器在应用于测试集时应使用选项 opts. 可能的选项在 PredictorFunction 中给出.
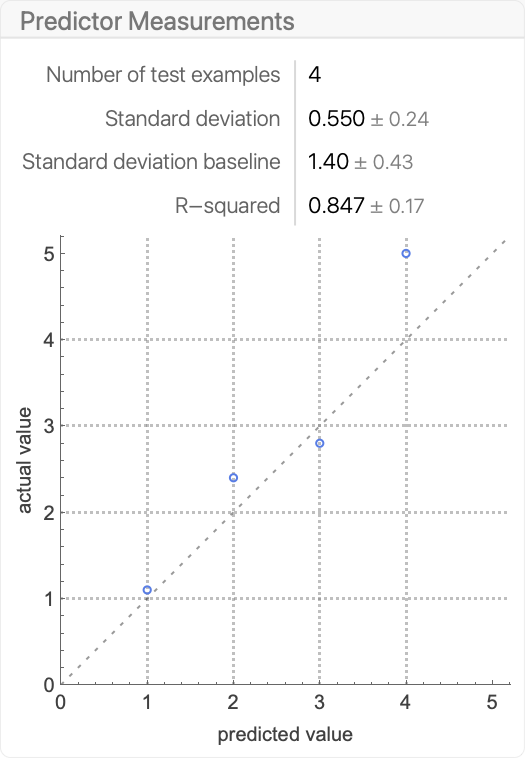
- PredictorMeasurements[predictor,testset] 返回一个显示为报告面板的 PredictorMeasurementsObject[…],如:
- PredictorMeasurementsObject[…][prop] 可用于从 PredictorMeasurementsObject 中查找 prop. 当需要重复属性查询时,这比每次使用 PredictorMeasurements 的方法更高效.
- PredictorMeasurementsObject[…][prop,opts] 指明预测器在应用于测试集时应使用选项 opts. 这些选项可取代给到 PredictorMeasurements 的原始选项.
- PredictorMeasurements 具有与 PredictorFunction[…] 相同的选项,并有以下增加:
-
Weights Automatic 与测试集范例相关的权值 ComputeUncertainty False 度量是否与其统计不确定性一起给出 - 当 ComputeUncertaintyTrue 时,数值度量会返回为 Around[result,err],其中,err 表示关联度量 result 的标准误差(对应于 68% 的置信区间).
- Weights 的可能设置包括:
-
Automatic 对全部范例关联权值 1 {w1,w2,…} 对第 i  个测试范例关联权值 wi
- 将测试范例的权值从 1 变为 2 等价于复制此范例.
- 权值影响度量及其不确定性.
- 返回与测试集上的预测能力相关的单个数值的属性包括:
-
"StandardDeviation" 残差的均方根 "StandardDeviationBaseline" 测试集值的标准偏差 "LogLikelihood" 给定测试数据,模型的对数似然 "MeanCrossEntropy" 在测试范例上的平均交叉熵 "MeanDeviation" 残差绝对值的平均值 "MeanSquare" 残差平方的平均值 "RSquared" 决定系数 "FractionVarianceUnexplained" 无法解释的方差的比例 "Perplexity" 平均交叉熵的指数 "RejectionRate" 样本预测结果为 Indeterminate 的比例 "GeometricMeanProbabilityDensity" 实际类概率密度的几何平均 - 当度量属性与测试集,例如, "StandardDeviation" 或 "MeanCrossEntropy" 上的预测能力相关时,分类为 Indeterminate 的测试范例会被丢弃.
- 返回图形的属性包括:
-
"ComparisonPlot" 绘图比较预测值和测试值 "ICEPlots" 个体条件期望 (ICE) 图 "ProbabilityDensityHistogram" 实际类概率密度的直方图 "Report" 报告主要测量的面板 "ResidualHistogram" 残差的直方图 "ResidualPlot" 残差图形 "SHAPPlots" 每个类别的 Shapley 可加和特征解释图 - 时间相关的属性包括:
-
"EvaluationTime" 预测一个范例所需的时间 "BatchEvaluationTime" 在给定批处理时预测一个范例的边际时间 - 为每个测试集范例返回一个值的属性包括:
-
"Residuals" 预测值与测试值之差的列表 "ProbabilityDensities" 实际类预测概率密度 "SHAPValues" 每个范例的 Shapley 可加特征归因 - "SHAPValues" 通过对不同特征集合的删除与合成比较预测来评估特征的贡献. 选项 MissingValueSynthesis 可用于指定如何合成缺失的特征. SHAP 解释是作为训练输出平均值的偏差给出的. "SHAPValues"n 可用于控制用于 SHAP 解释数值估计的样本数.
- 从测试集返回范例的属性包括:
-
"BestPredictedExamples" 具有最高实际类概率密度的范例 "Examples" 所有测试范例 "Examples"{i1,i2} 在区间 i1 中预测在区间 i2 中的范例 "LeastCertainExamples" 具有最高分布熵的范例 "MostCertainExamples" 具有最低分布熵的范例 "WorstPredictedExamples" 具有最低实际类概率密度的范例 - 范例以格式 inputivaluei 给出,其中,valuei 是实际值.
- 诸如 "WorstPredictedExamples" 或 "MostCertainExamples" 等属性输出至多 10 个范例. PredictorMeasurementsObject[…][propn] 可用于输出 n 个范例.
- 其他属性包括:
-
"PredictorFunction" 被测量的 PredictorFunction[…] "Properties" 可用的测量属性列表
范例
打开所有单元 关闭所有单元基本范例 (3)
p = Predict[{1 -> 2, 3 -> 4.5, 5 -> 6, 7 -> 8.5}]testset = {1.5 -> 2, 4 -> 5, 6 -> 5.5};PredictorMeasurements[p, testset, "StandardDeviation"]PredictorMeasurements[p, testset, "ResidualPlot"]PredictorMeasurements[p, testset, "ComparisonPlot"]PredictorMeasurements[p, testset, {"StandardDeviation", "RSquared", "MeanCrossEntropy"}]p = Predict[{1 -> 2, 3 -> 4.5, 5 -> 6, 7 -> 8.5}]pm = PredictorMeasurements[p, {1.5 -> 2, 4 -> 5, 6 -> 5.5}]pm["Properties"]pm["StandardDeviation"]pm["StandardDeviation", ComputeUncertainty -> True]pm[{"StandardDeviation", "RSquared"}, ComputeUncertainty -> True]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviation"]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}]PredictorMeasurements[{NormalDistribution[1, 1.2], NormalDistribution[2, 0.8], NormalDistribution[3, 1.9], NormalDistribution[4, 2.1]}, {1.1, 2.4, 2.8, 5}, "LogLikelihood"]范围 (3)
基于残差的度量 (1)
PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "ResidualPlot"]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviation"]Sqrt@Mean[PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "Residuals"] ^ 2]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviation", ComputeUncertainty -> True]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviationBaseline", ComputeUncertainty -> True]
PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "RSquared"]1 - PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviation"] ^ 2 / PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "StandardDeviationBaseline"] ^ 2PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "FractionVarianceUnexplained"]PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "RSquared"] + PredictorMeasurements[{1, 2, 3, 4}, {1.1, 2.4, 2.8, 5}, "FractionVarianceUnexplained"]比较图和范例提取 (1)
{training, test} = TakeDrop[RandomSample@ResourceData["Sample Data: Boston Homes"], 300];Dataset[training, MaxItems -> 5]p = Predict[training -> "MEDV"]pm = PredictorMeasurements[p, test]pm["WorstPredictedExamples" -> 2]#1 -> p[#1]&@@@pm["WorstPredictedExamples" -> 2]pm["BestPredictedExamples" -> 2]#1 -> p[#1]&@@@pm["BestPredictedExamples" -> 2]pm["ComparisonPlot"]提取真实值在 30 到 40 之间和预测值在 40 到 50 之间的范例:
pm["Examples" -> {{30, 40}, {40, 50}}]概率指标 (1)
生成并图示表达式 Cos[x*y] 的仿真数据集:
Plot3D[Cos[x * y], {x, -2, 2}, {y, -2, 2}]points = {##, Cos[#1 * #2] + RandomReal[{-.2, .2}]}&@@@RandomReal[{-2, 2}, {1000, 2}];ListPointPlot3D[points]{trainingset, testset} = TakeDrop[{#1, #2} -> #3&@@@points, 800];p = Predict[trainingset]PredictorMeasurements[p, testset, "LogLikelihood"]PredictorMeasurements[p, testset, "MeanCrossEntropy"]-PredictorMeasurements[p, testset, "LogLikelihood"] / Length[testset]选项 (5)
IndeterminateThreshold (1)
points = {#, Cos[#] + RandomReal[#]}& /@ RandomReal[{-3, 3}, {1000}];
dataset = Rule @@@ points;ListPlot[points]trainingset = dataset[[ ;; 800]];
testset = dataset[[801 ;; ]];p = Predict[trainingset]Plot[{
PDF[p[-2, "Distribution"], y],
PDF[p[-1, "Distribution"], y],
PDF[p[0., "Distribution"], y]
}, {y, -3, 2}, PlotRange -> All, PlotLegends -> "Expressions"]PredictorMeasurements[p, testset, "StandardDeviation"]PredictorMeasurements[p, testset, "StandardDeviation", IndeterminateThreshold -> 1]还可以用 PredictorMeasurementsObject 完成同样的计算:
pm = PredictorMeasurements[p, testset]pm["StandardDeviation", IndeterminateThreshold -> 1]Get["MachineLearning`"]
DiscretePlot[pm["StandardDeviation", IndeterminateThreshold -> x], {x, 0, 5, .5}, Joined -> True]DiscretePlot[pm["RejectionRate", IndeterminateThreshold -> x], {x, 0, 5, .5}, Joined -> True]TargetDevice (1)
trainingData = RandomReal[1, {2000, 4}] -> RandomReal[1, 2000];
predictor = Predict[trainingData, Method -> "NeuralNetwork"]
测量预测器在 TargetDevice 不同设置时对测试集的标准偏差:
testset = RandomReal[1, {10, 4}] -> RandomReal[1, 10];AbsoluteTiming[PredictorMeasurements[predictor, testset, "StandardDeviation", TargetDevice -> "GPU"]]AbsoluteTiming[PredictorMeasurements[predictor, testset, "StandardDeviation", TargetDevice -> "CPU"]]UtilityFunction (1)
trainingset = {1 -> 1.1, 2 -> 4.4, 3 -> 6.1, 4 -> 7.1, 5 -> 9.2};testset = {0.7 -> 1.3, 2.1 -> 4.7, 3.5 -> 5.8, 3.5 -> 6.6};p = Predict[trainingset]utility[a_, p_] := -Piecewise[{{Exp[p - a], a < p}, {Exp[3 * (a - p)], a ≥ p}}]Plot[utility[0, p], {p, -1, 2}]PredictorMeasurements[p, testset, "Residuals", UtilityFunction -> utility]PredictorMeasurements[p, testset, "Residuals"]使用 PredictorMeasurementsObject 时也可以指定效用函数:
pm = PredictorMeasurements[p, testset]pm["Residuals", UtilityFunction -> utility]"Uncertainty" (1)
training = ExampleData[{"MachineLearning", "WineQuality"}, "TrainingData"];p = Predict[training]用测试集生成 PredictorMeasurements[…] 对象:
test = ExampleData[{"MachineLearning", "WineQuality"}, "TestData"];pm = PredictorMeasurements[p, test]pm["StandardDeviation", ComputeUncertainty -> True]Dataset[AssociationMap[pm[#, ComputeUncertainty -> True]&, {"GeometricMeanProbabilityDensity", "MeanCrossEntropy", "MeanDeviation", "MeanSquare", "TotalSquare"}]]Weights (1)
p = Predict[{1 -> 2, 3 -> 4.5, 5 -> 6, 7 -> 8.5}]pm = PredictorMeasurements[p, {1.5 -> 2, 4 -> 5, 6 -> 5.5, 3 -> 5}, Weights -> {1.5, 3, 2, 1}]pm["StandardDeviation"]pm["StandardDeviation", Weights -> {1, 1, 1, 3}]pm["StandardDeviation", ComputeUncertainty -> True]pm["StandardDeviation", Weights -> {1, 1, 1, 3}, ComputeUncertainty -> True]应用 (2)
dataset = RandomSample[{#2, #3, #4} -> #1& @@@ExampleData[{"Statistics", "USCityTemperature"}]];RandomSample[dataset, 3] // TableFormtrainingset = dataset[[ ;; 200]];testset = dataset[[201 ;; ]];p = Predict[trainingset]用预测器和测试集生成 PredictorMeasurementsObject:
pm = PredictorMeasurements[p, testset]pm["MeanCrossEntropy"]pm["ComparisonPlot"]pm["Examples" -> {{30, 40}, {40, 60}}]pm["WorstPredictedExamples" -> 20]给定地区的一些特征值,训练一个可以预测波士顿地区房产中值的预测器:
p = Predict[ExampleData[{"MachineLearning", "BostonHomes"}, "TrainingData"], PerformanceGoal -> "Quality"]pm = PredictorMeasurements[p, ExampleData[{"MachineLearning", "BostonHomes"}, "TestData"]]pm["ResidualPlot"]pm["ResidualHistogram"]pm["StandardDeviation"]pm["StandardDeviation", ComputeUncertainty -> True]文本
Wolfram Research (2014),PredictorMeasurements,Wolfram 语言函数,https://reference.wolfram.com/language/ref/PredictorMeasurements.html (更新于 2021 年).
CMS
Wolfram 语言. 2014. "PredictorMeasurements." Wolfram 语言与系统参考资料中心. Wolfram Research. 最新版本 2021. https://reference.wolfram.com/language/ref/PredictorMeasurements.html.
APA
Wolfram 语言. (2014). PredictorMeasurements. Wolfram 语言与系统参考资料中心. 追溯自 https://reference.wolfram.com/language/ref/PredictorMeasurements.html 年