"DBSCAN" (機械学習メソッド)
- FindClusters,ClusterClassify,ClusteringComponentsのメソッド
- ノイズのあるアプリケーションの密度に基づいた空間クラスタリングを使って,データを類似要素のクラスタに分割する(DBSCAN).
詳細とサブオプション
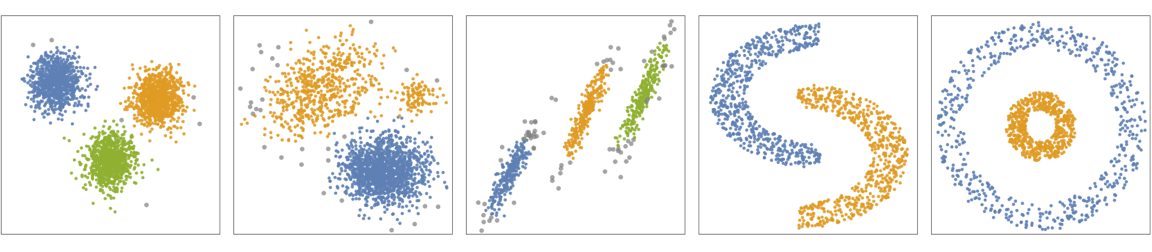
- "DBSCAN"(density-based spatial clustering of applications with noise,ノイズのあるアプリケーションの密度準拠空間クラスタリング)は,密度準拠のクラスタリングメソッドである.密度は近傍準拠のアプローチを使って推定される."DBSCAN"は任意の形や大きさのクラスタに使うことができるが,その場合のクラスタの密度は同じ程度でなければならない.
- 次のプロットは,"DBSCAN"法をトイデータ集合に適用した結果を示している(黒い点は外れ値を示す).
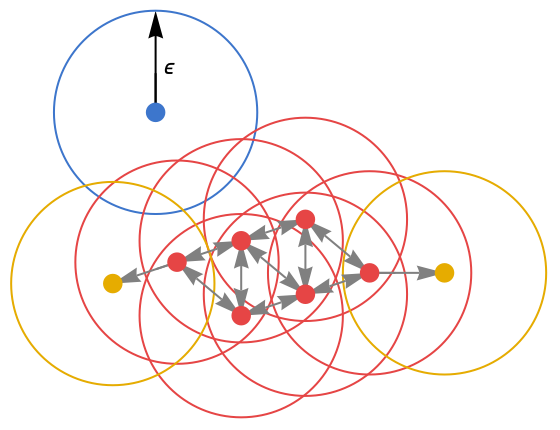
- "DBSCAN"は,半径 ϵ の球の中に k 個以上の近傍を持つ「コア点」(つまり,高密度領域内のデータ点)をデータ点として定義する.次に,互いの距離が ϵ 未満のコア点がクラスタを定義する.コア点からの距離が ϵ 未満の任意の点はそのコア点のクラスタに属す.コア点に近くない任意の点はノイズとみなされる.
- この結果,各クラスタのコアには1つあるいはそれ以上のコア点が,「エッジ」にはコア点ではない点が含まれることになる.全体として,"DBSCAN"はクラスタを連結された高密度領域として定義する.以下の図では,コア点が赤,エッジ点が黄色,ノイス点が青に彩色されている.
- ClusteringComponentsおよびClusterClassifyでは,ノイズ点にはMissing["Anomalous"]のラベルが付けられる.
- FindClustersでは,ノイズ点はクラスタとして返される.
- 使用する距離は,オプションDistanceFunctionで指定できる.
- 次は,使用可能なサブオプションである.
-
"NeighborhoodRadius" Automatic 半径 ϵ "NeighborsNumber" Automatic 近傍数 k "DropAnomalousValues" False 外れ値を削除するかどうか
例題
すべて開く すべて閉じる例 (3)
"DBSCAN"メソッドを使って近くの値のクラスタを求める:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25}, Method -> "DBSCAN"]"DBSCAN"メソッドを使ってClassifierFunctionを色のリストで訓練する:
colors = RandomColor[70];
c = ClusterClassify[colors, Method -> "DBSCAN"]GatherBy[colors, c]SeedRandom[123]
data = Join[RandomReal[1, {100, 2}], RandomReal[{-3, -.1}, {100, 2}]];
ListPlot[data]"DBSCAN"メソッドで求まった data 内のクラスタをプロットする:
ListPlot[FindClusters[data, Method -> "DBSCAN"]]スコープ (2)
data = TimeObject /@ RandomReal[AbsoluteTime[]//Round, 20]"DBSCAN"メソッドでClassifierFunctionを訓練する:
c = ClusterClassify[data, Method -> "DBSCAN"]assignment = c[data]
GatherBy[data, c]"DBSCAN"メソッドを使ってClassifierFunctionを訓練する:
data = {1000, 1, 2, 3, 1.1, 2, 9, 8, 7, 6, 4, 1, .5, 152, 153, 150, 145, -1000};
cc = ClusterClassify[data, Method -> "DBSCAN"]ノイズ点にはMissing["Anomalous"]のラベルが付けられる:
cc[data]オプション (7)
DistanceFunction (1)
"NeighborhoodRadius" (2)
"NeighborhoodRadius"サブオプションを指定してクラスタを求める:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25}, Method -> {"DBSCAN", "NeighborhoodRadius" -> 1}]やや曖昧な4つのクラスタによって特徴付けられた二次元のデータ点の集合を指定する:
dn1 = MultinormalDistribution[{4, 4}, {{2, 1 / 3}, {1 / 3, 2 / 3}}];
dn2 = MultinormalDistribution[{-3, -3}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
dn3 = MultinormalDistribution[{4, -4}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
dn4 = MultinormalDistribution[{-3, 4}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
data = RandomVariate[MixtureDistribution[{1, 1, 1, 1}, {dn1, dn2, dn3, dn4}], 400];

ListPlot[data]"DBSCAN"メソッドを使って求まった data 内のクラスタをプロットする:
ListPlot[FindClusters[data, Method -> "DBSCAN"]]"NeighborhoodRadius"を変え,"DBSCAN"メソッドを使って data の異なるクラスタリングをプロットする:
table = Table[ListPlot[FindClusters[data, Method -> {"DBSCAN", "NeighborhoodRadius" -> p}]], {p, {0.1, 0.2, 0.3}}];
	Grid[{table}, Frame -> All]
"NeighborsNumber" (3)
"NeighborsNumber"サブオプションを指定してクラスタを求める:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25, 30, 32}, Method -> {"DBSCAN", "NeighborsNumber" -> 3}]data = Join[RandomReal[1, {100, 2}], RandomReal[{-3, -.1}, {100, 2}]];
ListPlot[data]"DBSCAN"メソッドで求まった data 内のクラスタをプロットする:
ListPlot[FindClusters[data, Method -> "DBSCAN"]]"NeighborsNumber"を変えて,"DBSCAN"メソッドを使った data の異なるクラスタリングをプロットする:
table = Table[ListPlot[FindClusters[data, Method -> {"DBSCAN", "NeighborsNumber" -> p}]], {p, {3, 5, 10}}];
Grid[{table}, Frame -> All]
やや曖昧な4つのクラスタによって特徴付けられた二次元のデータ点の集合を指定する:
dn1 = MultinormalDistribution[{4, 4}, {{2, 1 / 3}, {1 / 3, 2 / 3}}];
dn2 = MultinormalDistribution[{-3, -3}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
dn3 = MultinormalDistribution[{4, -4}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
dn4 = MultinormalDistribution[{-3, 4}, {{2, -1 / 3}, {-1 / 3, 2 / 3}}];
data = RandomVariate[MixtureDistribution[{1, 1, 1, 1}, {dn1, dn2, dn3, dn4}], 400];

ListPlot[data]"DBSCAN"メソッドを使って求まった data 内のクラスタをプロットする:
ListPlot[FindClusters[data, Method -> "DBSCAN"]]"NeighborsNumber"を変て,"DBSCAN"メソッドを使って data の異なるクラスタリングをプロットする:
table = Table[ListPlot[FindClusters[data, Method -> {"DBSCAN", "NeighborsNumber" -> p}]], {p, {5, 30, 50}}];
Grid[{table}, Frame -> All]
"DropAnomalousValues" (1)
外れ値にMissing["Anomalous"]のラベルを付けるClassifierFunctionを訓練する:
ndata = {1000, 1, 2, 3, 1.1, 2, 9, 8, 7, 6, 4, 1, .5, 152, 153, 150, 145, -1000};
cc = ClusterClassify[ndata, Method -> "DBSCAN"]訓練されたClassifierFunctionを使って外れ値を識別する:
cc[ndata]外れ値を削除してClassifierFunctionを訓練し,新たなクラスタ割当てを求める:
cc = ClusterClassify[ndata, Method -> {"DBSCAN", "DropAnomalousValues" -> True}]
cc[ndata]FindClusters[ndata, Method -> "DBSCAN"]"DropAnomalousValues"サブオプションを使って外れ値を除く:
FindClusters[ndata, Method -> {"DBSCAN", "DropAnomalousValues" -> True}]
 An Elementary Introduction to the Wolfram Language