

ClassifierMeasurements
ClassifierMeasurements[classifier,testset,prop]
给出当 classifier 在 testset 上运算时与属性 prop 关联的度量.
ClassifierMeasurements[classifier,testset]
生成一个可应用于任何属性的度量报告.
ClassifierMeasurements[data,…]
使用分类 data 而非分类器.
ClassifierMeasurements[…,{prop1,prop2,…}]
给出属性 prop1、prop2 等.
更多信息和选项
- 度量用于决定不用作训练目的(测试集)的数据分类器的性能.
- 可能的度量包括分类指标(准确性、似然性等)、可视化(混淆矩阵、受试者操作特征曲线(简称 ROC 曲线)等),或特定样例(如最糟的分类样例).
- 分类器可以是一个 ClassifierFunction 或一个有 "Class" 解码器的神经集(NetGraph、NetChain) 等.
- 在 ClassifierMeasurements[data,…] 中,分类 data 可有如下格式:
-
{class1,class2,…} 来自分类器的分类(人类、算法等) {dist1,dist2,…} 分类器获取的类别分布 {<class1p1,…>,<class1q1,…>,…} 分类器获取的分类概率 - ClassifierMeasurements[…,opts] 指定分类器在应用于测试集时应使用选项 opts. ClassifierFunction 给出了可能的选项.
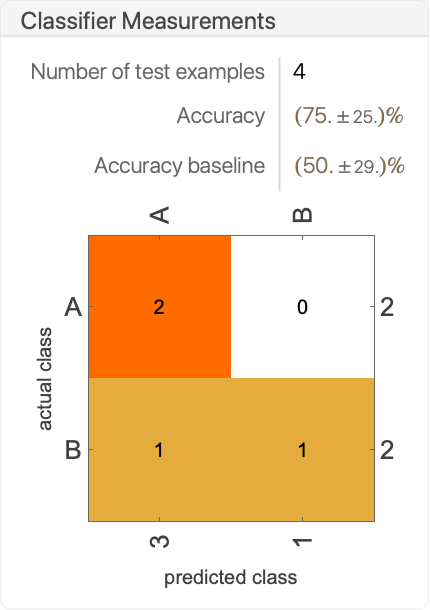
- ClassifierMeasurements[classifier,testset] 返回一个显示为一个报告面板的 ClassifierMeasurementsObject[…],如:
- ClassifierMeasurementsObject[…][prop] 可用于获取属性 prop. 当需要重复属性查询时,这会比每次都使用 ClassifierMeasurements 效率更高.
- ClassifierMeasurementsObject[…][prop,opts] 指定分类器在应用于测试集时应使用选项 opts. 这些选项可取代给到 ClassifierMeasurements 的原始选项.
- ClassifierMeasurements 与 ClassifierFunction[…] 的选项相同,额外选项如下所示:
-
Weights Automatic 与测试集的实例相关联的权重 ComputeUncertainty False 是否同时给出度量的统计不确定性 - 当设置为 ComputeUncertaintyTrue 时,将以 Around[result,err] 形式返回数值测量结果,其中 err 表示与测量 result 相关的标准偏差(对应于 68% 的置信区间).
- Weights 的可能设置包括:
-
Automatic 将权重 1 与所有测试实例关联起来 {w1,w2,…} 将权重 wi 与第 i  个测试实例关联起来
- 把测试实例的权重从 1 改为 2 等价于复制该实例.
- 权重影响度量和它们的不确定性.
- 返回与测试集上的分类能力相关的单个数值的属性包括:
-
"Accuracy" 正确分类实例的比例 "Accuracy"n 前 n 个准确率 "AccuracyBaseline" 如果预测最常见类的准确率 "CohenKappa" 科恩卡帕系数 "Error" 被错误分类实例的比例 "GeometricMeanProbability" 实际类别概率的几何平均 "LogLikelihood" 给出测试集的模型的对数似然 "MeanCrossEntropy" 测试实例的平均交叉熵 "MeanDecisionUtility" 测试实例的平均效用 "Perplexity" 平均交叉熵的指数 "RejectionRate" 被划分为 Indeterminate 的实例的比例 "ScottPi" Scott pi 系数 - 在测量与测试集上的分类能力相关的属性(如 "Accuracy"、"Error" 或 "MeanCrossEntropy")时,被分类为 Indeterminate 的实例将被丢弃.
- 与混淆矩阵相关的属性包括:
-
"ConfusionMatrix" 按 cij 类別 j 分类的类别 i 实例的計数 "ConfusionMatrixPlot" 混淆矩阵图形 "ConfusionMatrixPlot"{c1,c2,…} 限制于类别 c1、c2 等的混淆矩阵图 "ConfusionMatrixPlot"n 最差的 n 个类别组成的子集的混淆矩阵图 "ConfusionFunction" 给出混淆矩阵值的函数 "TopConfusions" 混淆程度最高的类别对 "TopConfusions"n 混淆程度最高的 n 个类别对 - 与用时相关的属性包括:
-
"EvaluationTime" 分类一个样例需要的时间 "BatchEvaluationTime" 当给定一批预测一个样例的边际时间 - 为测试集的每个实例返回一个值的属性包括:
-
"DecisionUtilities" 每个样例的效用函数的值 "Probabilities" 每个样例的实际类别分类概率 "SHAPValues" 每个样例的 Shapley 加性特征解释 - "SHAPValues" 通过比较将不同的特征集合删除,然后合成所得到的预测来评估特征的贡献. 选项 MissingValueSynthesis 可用于指定如何合成缺失的特征. SHAP 解释是以相对于 class training prior 的优势比乘数 (odds ratio multiplier) 给出的. 可通过 "SHAPValues"n 控制用于对 SHAP 解释进行数值估计的样本的数量.
- 与概率校准的属性包括:
-
"CalibrationCurve" Logit 标尺中的概率校准曲线 "LinearCalibrationCurve" 线性标尺中的概率校准曲线 "CalibrationData" 概率校准曲线数据 - 返回图形的属性包括:
-
"AccuracyRejectionPlot" 作为拒绝率函数的准确率的绘图 "ICEPlots" 个体条件期望 (ICE) 图 "ProbabilityHistogram" 实际类别概率的直方图 "Report" 报告主要度量的面板 "ROCCurve" 每个类别的接收者操作特征曲线 "SHAPPlots" 每个类别的 Shapley 加性特征解释图 - 从测试集返回实例的属性包括:
-
"Examples" 所有测试实例 "Examples"{i,j} 被划分为 j 类的所有 i 类实例 "BestClassifiedExamples" 实际类别概率最高的实例 "WorstClassifiedExamples" 实际类别概率最低的实例 "CorrectlyClassifiedExamples" 被正确分类的实例 "MisclassifiedExamples" 被错误分类的实例 "TruePositiveExamples" 每个类别的真正类测试实例 "FalsePositiveExamples" 每个类别的假正类测试实例 "TrueNegativeExamples" 每个类别的真负类测试实例 "FalseNegativeExamples" 每个类别的假负类测试实例 "IndeterminateExamples" 被划分为 Indeterminate 的测试实例 "LeastCertainExamples" 分布熵最高的实例 "MostCertainExamples" 分布熵最低的实例 - 以 inputiclassi 形式给出实例,其中 classi 是测试集中实例的实际类别.
- 如 "WorstClassifiedExamples" 或 "MostCertainExamples" 这样的属性最多输出 10 个实例. ClassifierMeasurementsObject[…][propn] 可用来输出 n 个实例.
- 为每个类返回一个测量值的属性包括:
-
"AreaUnderROCCurve" 每个类别的 ROC 曲线下的面积 "ClassMeanCrossEntropy" 每个类别的平均交叉熵 "ClassRejectionRate" 每个类别的拒绝率 "F1Score" 每个类别的 F1 值 "FalseDiscoveryRate" 每个类别的错误发现率 "FalseNegativeRate" 每个类别的假负类率 "FalsePositiveRate" 每个类别的假正类率 "MatthewsCorrelationCoefficient" 每个类别的 Matthews 相关系数 "NegativePredictiveValue" 每个类别的负例命中率 "Precision" 每个类别的分类的精确度 "Recall" 每个类别的分类的召回率 "Specificity" 每个类别的特异性 "TruePositiveNumber" 真正类实例的数量 "FalsePositiveNumber" 假正类实例的数量 "TrueNegativeNumber" 真负类实例的数量 "FalseNegativeNumber" 假负类实例的数量 - ClassifierMeasurementsObject[…][propclass] 可用来仅返回与指定类别关联的测量值.
- ClassifierMeasurementsObject[…][prop<class1w1,class2w2,…>] 可用来返回每个类别测量值的加权平均值.
- ClassifierMeasurementsObject[…][propf] 可用来对返回的类别测量值应用函数 f(如 ClassifierMeasurementsObject[…][propMean]).
- 如 "Precision" 或 "Recall" 这样的属性为每个可能的“正类”给出一个测量值. “负类”是所有非“正类”的类的组合. 对于这样的属性,我们可以用 ClassifierMeasurementsObject[…][propaverage] 求所有可能的正类的测量值的平均值,其中 average 可以是:
-
"MacroAverage" 所有测量值的统一平均值 "WeightedMacroAverage" 根据相关的类的频次对每个测量值进行加权 "MicroAverage" 合并真正类/真负类等实例,给出唯一的测量值 - 其他属性包括:
-
"ClassifierFunction" 当前被测量的 ClassifierFunction[…] "Properties" 可用测量属性列表
范例
打开所有单元 关闭所有单元基本范例 (4)
度量测试集上 ClassifierFunction 的准确度:
ClassifierMeasurements[ClassifierFunction[Association["ExampleNumber" -> 6, "ClassNumber" -> 2,
  "Input" -> Association["Preprocessor" -> MachineLearning`MLProcessor["ToMLDataset",
      Association["Input" -> Association["f1" -> Association["Type" -> "Numerical"]],
 ... -> DateObject[{2025, 11, 6, 16, 12,
       52.1822776`9.470097878158642}, "Instant", "Gregorian", -6.], "ProcessorCount" -> 4,
    "ProcessorType" -> "x86-64", "OperatingSystem" -> "Windows", "SystemWordLength" -> 64,
"Evaluations" -> {}]]], {2.2 -> "A", 2.7 -> "A", 4.5 -> "B", 1.4 -> "B"}, "Accuracy"]c = Classify[{1 -> "A", 2 -> "A", 3.5 -> "B", 4 -> "A", 5 -> "B", 6 -> "B"}]cm = ClassifierMeasurements[c, {2.2 -> "A", 2.7 -> "A", 4.5 -> "B", 1.4 -> "B"}]ClassifierMeasurements[{<|"A" -> 0.9, "B" -> 0.1|>, <|"A" -> 0.8, "B" -> 0.2|>, <|"A" -> 0.2, "B" -> 0.8|>, <|"A" -> 0.6, "B" -> 0.4|>}, {"A", "A", "B", "B"}, "MeanCrossEntropy"]ClassifierMeasurements[NetChain[Association["Type" -> "Chain",
"Nodes" -> Association["1" -> Association["Type" -> "Linear",
"Arrays" -> Association["Weights" -> NumericArray[{{-0.36878493428230286},
{0.7268890738487244}}, "Real32"], "Biases" -> Nume ... ls" -> {"A", "B"},
"InputDepth" -> 1, "Multilabel" -> False, "Dimensions" -> 2, "$Rank" -> 0,
"$Version" -> "15.0.1"], NeuralNetworks`TensorT[{2}, NeuralNetworks`RealT]]]],
Association["Version" -> "15.0.1", "Unstable" -> False]], {2.2 -> "A", 2.7 -> "A", 4.5 -> "B", 1.4 -> "B"}, "ConfusionMatrixPlot"]范围 (7)
决定指标 (3)
ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, "Accuracy"]ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, "Accuracy", ComputeUncertainty -> True]将准确率与基线进行对比(总是预测最有可能的测试集类别,在这个例子中是 "B"):
ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, "AccuracyBaseline", ComputeUncertainty -> True]ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, "Error"]Total@ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, {"Accuracy", "Error"}]ClassifierMeasurements[{"A", "A", "B", "A", "B"}, {"A", "A", "B", "B", "B"}, "Accuracy", Weights -> {1, 1, 1, 2, 2}]{training, test} = TakeDrop[RandomSample[ResourceData["MNIST"], 2000], 1000];training//Shortc = Classify[training]ClassifierMeasurements[c, test, "Accuracy", ComputeUncertainty -> True]在测试集中计算模型”最高的三个“准确率(在三个预测类别中真实类别的概率最高则分类被认为是正确的):
ClassifierMeasurements[c, test, "Accuracy" -> 3, ComputeUncertainty -> True]在已分类样例上其真实标签的测量 Cohen's kappa 系数:
ClassifierMeasurements[{"A", "A", "B", "A"}, {"A", "A", "B", "B"}, "CohenKappa"]ClassifierMeasurements[{"A", "A", "B", "A"}, {"A", "A", "B", "B"}, "ScottPi"]混淆矩阵和样例提取 (1)
{training, test} = TakeDrop[RandomSample[ResourceData["MNIST"], 2000], 1000];training//Shortc = Classify[training]cm = ClassifierMeasurements[c, test]cm["WorstClassifiedExamples" -> 10]#1 -> c[#1, "Probability" -> #2]&@@@cm["WorstClassifiedExamples" -> 10]cm["BestClassifiedExamples" -> 10]#1 -> c[#1, "Probability" -> #2]&@@@cm["BestClassifiedExamples" -> 10]cm["ConfusionMatrixPlot"]cm["ConfusionMatrix"]cm["ConfusionFunction"][3, 5]cm["TopConfusions" -> 5]cm["ConfusionMatrixPlot" -> 3]cm["ConfusionMatrixPlot" -> -3]cm["ConfusionMatrixPlot" -> {1, 4, 9}]cm["Examples" -> {4, 9}]概率指标 (1)
fisher = ResourceData["Sample Data: Fisher's Irises"]//Dataset[#, MaxItems -> 5]&{training, test} = TakeDrop[RandomSample[fisher], 100];iris = Classify[training -> "Species"]ClassifierMeasurements[iris, test, "LogLikelihood"]ClassifierMeasurements[iris, test, "MeanCrossEntropy"]-ClassifierMeasurements[iris, test, "LogLikelihood"] / Length[test]ClassifierMeasurements[iris, test, "GeometricMeanProbability"]Exp[-ClassifierMeasurements[iris, test, "MeanCrossEntropy"]]概率校准 (1)
{training, test} = TakeDrop[RandomSample[ResourceData["MNIST"], 8000], 4000];c1 = Classify[training, Method -> "RandomForest", RecalibrationFunction -> None]在 Logit 标尺中可视化测试集中分类器的可靠性图表(即校准曲线):
ClassifierMeasurements[c1, test, "CalibrationCurve"]ClassifierMeasurements[c1, test, "LinearCalibrationCurve"]c2 = Classify[training, Method -> "RandomForest"]ClassifierMeasurements[c2, test, "CalibrationCurve"]ClassifierMeasurements[c2, test, "LinearCalibrationCurve"]二进制分类指标 (1)
fisher = ResourceData["Sample Data: Fisher's Irises"]//Dataset[#, MaxItems -> 5]&{training, test} = TakeDrop[RandomSample[fisher], 100];iris = Classify[training -> "Species"]ClassifierMeasurements[iris, test, "ROCCurve"]ClassifierMeasurements[iris, test, "AreaUnderROCCurve"]ClassifierMeasurements[iris, test, "F1Score"]ClassifierMeasurements[iris, test, "F1Score" -> "versicolor"]ClassifierMeasurements[iris, test, "ClassAccuracy" -> "MacroAverage"]ClassifierMeasurements[iris, test, "ClassAccuracy" -> "WeightedMacroAverage"]通过将真正类/真负类等所有类别的样例合在一起计算 F1 分数,给出一个唯一度量:
ClassifierMeasurements[iris, test, "ClassAccuracy" -> "MicroAverage"]选项 (6)
ClassPriors (1)
trainingset = ExampleData[{"MachineLearning", "Satellite"}, "TrainingData"];testset = ExampleData[{"MachineLearning", "Satellite"}, "TestData"];c = Classify[trainingset]ClassifierMeasurements[c, testset, "ConfusionMatrixPlot"]当分类器具有 ClassPriors 的不同值时,可视化获得的混淆矩阵:
ClassifierMeasurements[c, testset, "ConfusionMatrixPlot", ClassPriors -> <|"cotton crop" -> 0.5, "gray soil" -> 0.5|>]通过首先生成 ClassifierMeasurementsObject,执行相同的操作:
cm = ClassifierMeasurements[c, testset];cm["ConfusionMatrixPlot", ClassPriors -> <|"cotton crop" -> 0.5, "gray soil" -> 0.5|>]IndeterminateThreshold (1)
trainingset = ExampleData[{"MachineLearning", "Titanic"}, "TrainingData"];testset = ExampleData[{"MachineLearning", "Titanic"}, "TestData"];c = Classify[trainingset, Method -> "LogisticRegression"]ClassifierMeasurements[c, testset, "ConfusionMatrixPlot"]当分类器具有 IndeterminateThreshold 的不同值时,可视化获得的混淆矩阵:
ClassifierMeasurements[c, testset, "ConfusionMatrixPlot", IndeterminateThreshold -> 0.8]对于 IndeterminateThreshold 的不同值,度量测试集上分类器的准确度:
cm = ClassifierMeasurements[c, testset]cm["Accuracy", IndeterminateThreshold -> #] & /@ {0., 0.6, 0.8, 0.9}cm["AccuracyRejectionPlot"]TargetDevice (1)
trainingData = RandomReal[1, {2000, 4}] -> RandomChoice[{"a", "b", "c", "d"}, 2000];
classifier = Classify[trainingData, Method -> "NeuralNetwork"]
对 TargetDevice 不同设置的测试集度量分类器的精确度:
testset = RandomReal[1, {10, 4}] -> RandomChoice[{"a", "b", "c", "d"}, 10];AbsoluteTiming[ClassifierMeasurements[classifier, testset, "Accuracy", TargetDevice -> "GPU"]]AbsoluteTiming[ClassifierMeasurements[classifier, testset, "Accuracy", TargetDevice -> "CPU"]]UtilityFunction (1)
trainingset = ExampleData[{"MachineLearning", "Mushroom"}, "TrainingData"];testset = ExampleData[{"MachineLearning", "Mushroom"}, "TestData"];c = Classify[RandomSample[trainingset, 100]]ClassifierMeasurements[c, testset, "ConfusionMatrixPlot"]当分类器具有 UtilityFunction 的不同值时,可视化获得的混淆矩阵:
utility = <|
	"edible" -> <|"edible" -> 1, "poisonous" -> 0, Indeterminate -> 0.5|>,
	"poisonous" -> <|"edible" -> -10, "poisonous" -> 1, Indeterminate -> 0.8|>
|>;ClassifierMeasurements[c, testset, "ConfusionMatrixPlot", UtilityFunction -> utility]通过首先生成 ClassifierMeasurementsObject,执行相同的操作:
cm = ClassifierMeasurements[c, testset]cm["ConfusionMatrixPlot", UtilityFunction -> utility]ComputeUncertainty (1)
训练一个分类器,把影评片段分类为 "positive" 或 "negative":
training = ExampleData[{"MachineLearning", "MovieReview"}, "TrainingData"];c = Classify[ExampleData[{"MachineLearning", "MovieReview"}, "TrainingData"]]用测试集生成一个 ClassifierMeasurements[…] 对象:
test = ExampleData[{"MachineLearning", "MovieReview"}, "TestData"];cm = ClassifierMeasurements[c, test]cm["Accuracy", ComputeUncertainty -> True]Dataset[AssociationMap[cm[#, ComputeUncertainty -> True]&, {"AreaUnderROCCurve" -> "positive", "CohenKappa", "Error", "F1Score" -> "positive", "GeometricMeanProbability", "MatthewsCorrelationCoefficient" -> "positive", "MeanCrossEntropy", "Precision" -> "positive", "Recall" -> "positive", "ScottPi"}]]Weights (1)
c = Classify[{1 -> "A", 2 -> "A", 3.5 -> "B", 4 -> "A", 5 -> "B", 6 -> "B"}]cm = ClassifierMeasurements[c, {2.2 -> "A", 2.7 -> "A", 4.5 -> "B", 1.4 -> "B"}, Weights -> {1.5, 3, 2, 1}]cm["Accuracy"]cm["Accuracy", Weights -> {1, 1, 1, 3}]cm["Accuracy", ComputeUncertainty -> True]cm["Accuracy", Weights -> {1, 1, 1, 3}, ComputeUncertainty -> True]应用 (2)
对于费雪鸢尾花卉数据集,训练一个分类器,使其从四个测得特征来预测鸢尾花卉的种类(山鸢尾、变色鸢尾和维吉尼亚鸢尾):
c = Classify[ExampleData[{"MachineLearning", "FisherIris"}, "TrainingData"]]cm = ClassifierMeasurements[c, ExampleData[{"MachineLearning", "FisherIris"}, "TestData"]]cm["Accuracy"]生成一个混淆矩阵,对试验数据的实际分类和利用分类器的预测分类进行可视化:
cm["ConfusionMatrixPlot"]对错误归类为 "virginica" 的类别 "versicolor" 的实例进行提取:
cm["Examples" -> {"versicolor", "virginica"}]cm["ConfusionFunction"]{training, test} = TakeDrop[RandomSample[ResourceData["MNIST"], 8000], 4000];c = Classify[training]生成 MNIST 测试集上分类器的 ClassifierMeasurementsObject:
cm = ClassifierMeasurements[c, ExampleData[{"MachineLearning", "MNIST"}, "TestData"]]cm["Examples" -> {9, 0}]cm["WorstClassifiedExamples" -> 20]cm["F1Score"]cm["AccuracyRejectionPlot"]cm["ConfusionMatrixPlot", IndeterminateThreshold -> 0.15]cm["F1Score", IndeterminateThreshold -> 0.67]cm["ConfusionMatrixPlot" -> 3, IndeterminateThreshold -> 0.67]文本
Wolfram Research (2014),ClassifierMeasurements,Wolfram 语言函数,https://reference.wolfram.com/language/ref/ClassifierMeasurements.html (更新于 2021 年).
CMS
Wolfram 语言. 2014. "ClassifierMeasurements." Wolfram 语言与系统参考资料中心. Wolfram Research. 最新版本 2021. https://reference.wolfram.com/language/ref/ClassifierMeasurements.html.
APA
Wolfram 语言. (2014). ClassifierMeasurements. Wolfram 语言与系统参考资料中心. 追溯自 https://reference.wolfram.com/language/ref/ClassifierMeasurements.html 年