"CUDA" (外部評価システム)
詳細
- CUDA 12.0以降がサポートされる.
- Wolfram言語は,インストールされているCUDA GPUを自動的に使用する.CUDA GPUが利用できない場合はCUDAの実行は動作しない.高度な設定が行いたい場合は,CUDAプログラミングワークフローの指示に従うとよい.
ExternalEvaluateの使用法
- ExternalEvaluate["CUDA",func]はWolfram Compilerを使って,コンパイル関数 func を,CUDA GPU上で実行できるカーネルを表すExternalFunctionにコンパイルする.
- ExternalEvaluate["CUDA",str]はCUDAツールキットを使って,C++コードの文字列を,CUDA GPU上で実行できるカーネルを表すExternalFunctionにコンパイルする.
- ExternalEvaluate["CUDA",file]はCUDAツールキットを使って,C++コードのファイルを,CUDA GPU上で実行できるカーネルを表すExternalFunctionにコンパイルする.
- CUDA GPU上で実行するためにコンパイルされたコードはCUDAカーネルとも言われる.
- ExternalFunctionオブジェクトに保存されているCUDAカーネルは,それを引数に割り当てることによって実行することができる.
- CUDAカーネルがGPU上で実行するとき,関数は複数のGPUプロセッサ上で並列で実行される.これはオプション"BlockDimensions"および"GridDimensions"で制御される:
- 次のオプションがサポートされる:
-
"BlockDimensions" Automatic 各ブロック上でスレッドがどのように実行するかを指定する "GridDimensions" Automatic 格子上でブロックがどのように実行するかを指定する - "BlockDimensions"および"GridDimensions"に可能な設定には次がある:
-
Automatic 入力のサイズを調べることで値を選択する x 一次元設定 {x,y} 二次元設定 {x,y,z} 三次元設定
Wolfram言語のデータ型
- CUDAにコンパイルされるWolfram言語関数には,スカラーおよび配列を表す低レベルの型を持つ引数が必要である.
-
"CArray"::[ty] GPUArray GPUに保存される数値データの配列 "CArray"::[ty] NumericArray CPUに保存される数値データの配列 "CArray"::[ty] ExternalObject ExternalObjectに保存される数値データの配列 "Integer64","Integer32", etc. Integer 整数 "Real64","Real32", etc. Real 実数 "ComplexReal32","ComplexReal64",etc. Complex 複素数 - CUDAにコンパイルされるWolfram言語関数によって使われる型は,Wolfram Compilerで使われるものである.
C++のデータ型
- CUDAにコンパイルされるC++コードには,スカラーおよび配列を表す低レベルの型を持つ引数が必要である.
-
ty* GPUArray GPUに保存される数値データの配列 ty* NumericArray CPUに保存される数値データの配列 ty* ExternalObject ExternalObjectに保存される数値データの配列 int, long, etc. Integer 整数 double,float, etc. Real 実数
サポートされる外部操作
- ExternalOperation["Function","code"]はWolfram言語またはC++のコードを,CUDA GPUで実行できるカーネルを表すExternalFunctionにコンパイルする.
- ExternalOperation["Program","code"]はWolfram言語またはC++のコードを,CUDA GPUで実行できるカーネルを表す複数の外部関数オブジェクトを含む外部オブジェクトにコンパイルする.
- ExternalOperation["HostFunction","code"]はC++のコードを,ホスト(通常CPU)上で実行できるホストコードを表すExternalFunctionにコンパイルする.
- ExternalOperation["HostProgram","code"]はC++のコードを,ホスト(通常CPU)上で実行できるホストコードを表す複数の外部関数オブジェクトを含む外部オブジェクトにコンパイルする.
例題
すべて開く すべて閉じる例 (4)
Wolfram言語コードを,CUDA GPU上で実行できるCUDAカーネルを含むExternalFunctionにコンパイルする:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"::["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 5]
	];
	]
]]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Integer64"]];gpuFun[data, 10]Normal[data]C++コードを,CUDA GPU上で実行できるCUDAカーネルを含むExternalFunctionにコンパイルする:
code = "#include \"WolframLibrary.h\"
__global__ void addFun(double *x, mint N) {
    const int tid =  blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < N) {
        x[tid] = x[tid] + 5;
    }
}";
gpuFun = ExternalEvaluate["CUDA", code]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "increment_kernel.cu"}]];
FilePrint[file]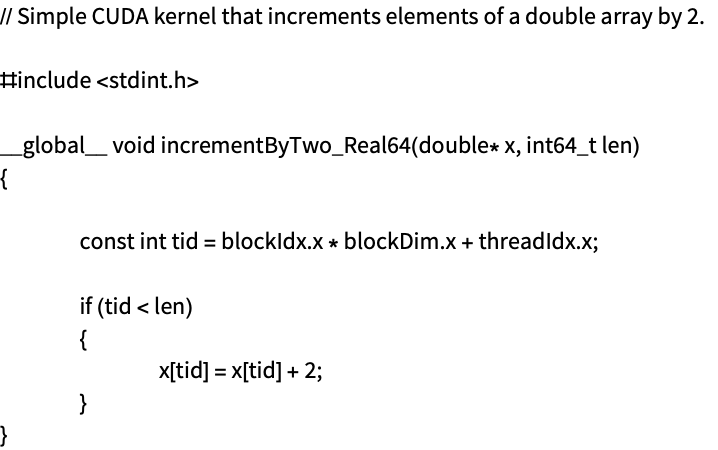
ファイルの中のC++コードを,CUDA GPU上で実行できるCUDAカーネルを含むExternalFunctionにコンパイルする:
gpuFun = ExternalEvaluate["CUDA", file]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]session = StartExternalSession["CUDA"]ExternalEvaluateの外部セッションを使って,CUDA GPU上で実行できるCUDAカーネルを含むExternalFunctionにWolfram言語コードをコンパイルする:
gpuFun = ExternalEvaluate[session, Function[{Typed[x, "CArray"::["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 5]
	];
	]
]]GPUArrayを使って,CUDAコードへの引数として使用できるデータをGPU上に格納する:
data = GPUArray[NumericArray[Range[10], "Integer64"]];gpuFun[data, 10]Normal[data]CUDAのインストールに関する問題についての情報を得るには,外部セッションを開始すると便利である.また,CUDAProgrammingワークフロー内の説明もきわめて有用である.
スコープ (11)
Wolfram言語コード (1)
func = Function[{Typed[x, "CArray"["Real64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 2]
	];
	]
	];
ExternalOperation "Function"を使ってコンパイルすることができる:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", func]]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]追加のコード宣言はFunctionDeclarationで与えることができる:
decl = FunctionDeclaration[increment, Typed[{"Real64"} -> "Real64"]@Function[arg, arg + 1]];func = Function[{Typed[x, "CArray"["Real64"]], Typed[n, "MachineInteger"]},
Module[{id},
id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
If[id < n,
ToRawPointer[ x, id, increment[FromRawPointer[ x, id]]]
];
]
];宣言と関数の両方を使って,ExternalOperation "Function"でコンパイルすることができる:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", decl, func]]data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]data//NormalC++コード (4)
code = "#include \"WolframLibrary.h\"
__global__ void addFun(double *x, mint N) {
    const int tid =  blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < N) {
        x[tid] = x[tid] + 5;
    }
}";
ExternalOperation "Function"を使ってコンパイルする:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", code]]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "increment_kernel.cu"}]];
FilePrint[file]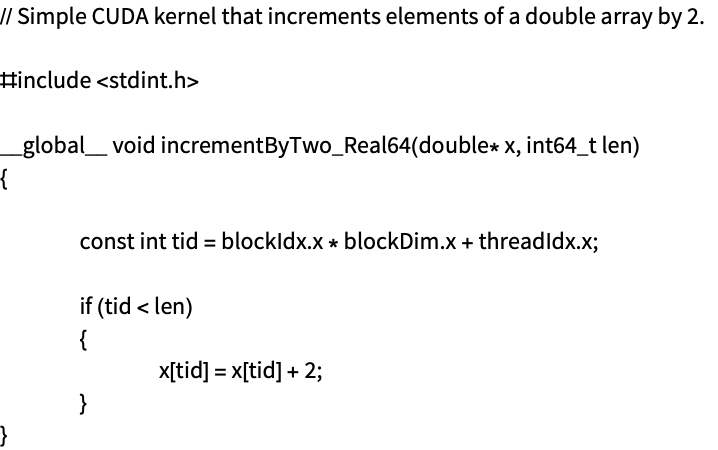
ExternalOperation "Function"を使ってコンパイルする:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", file]]GPUArrayを使って,CUDAコードの引数として使うことのできるデータをGPU上に保存する:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]GPU上で実行できる2つの関数を含むC++コードのファイル:
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "arithmetic_kernels.cu"}]];
FilePrint[file]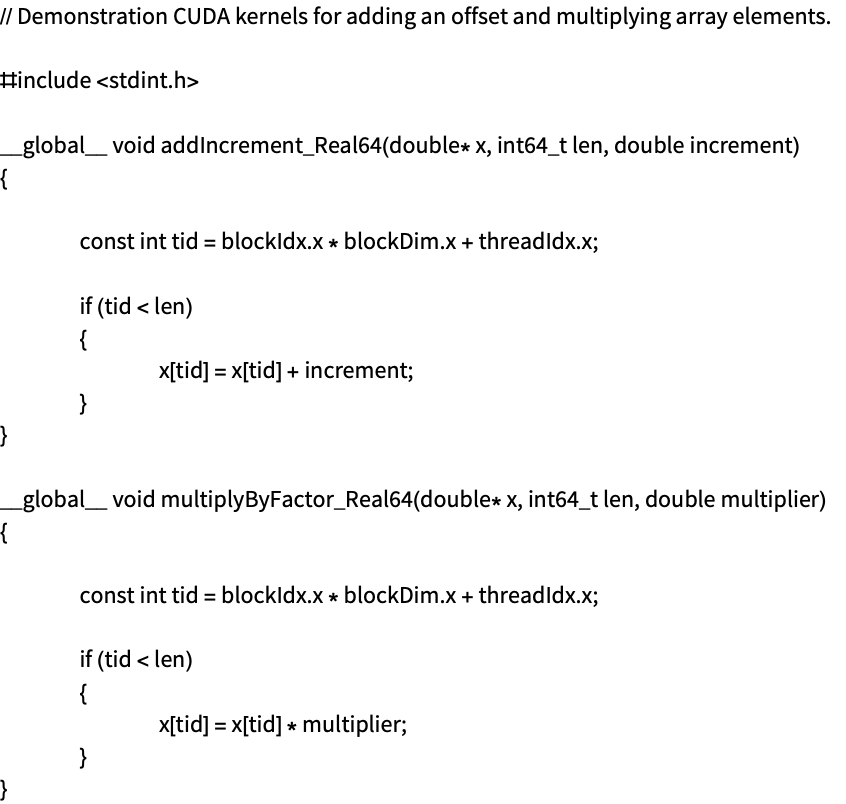
ExternalOperation "Program" を使い,コードをExternalObjectにコンパイルする:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["Program", file]]compFuns["Functions"]data = GPUArray[NumericArray[Range[10], "Real64"]];
compFuns["Functions"]["addIncrement_Real64"][data, 10, 42]Normal[data]data = GPUArray[NumericArray[Range[10], "Real64"]];
compFuns["Functions"]["multiplyByFactor_Real64"][data, 10, 42]Normal[data]関数が同じ名前でオーバーロードされる場合,名前修飾を使った関連が利用できる:
compFuns["FunctionsByMangledName"]C++のテンプレートを使う関数を含むC++コードのファイル:
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "scale_kernel.cu"}]];
FilePrint[file]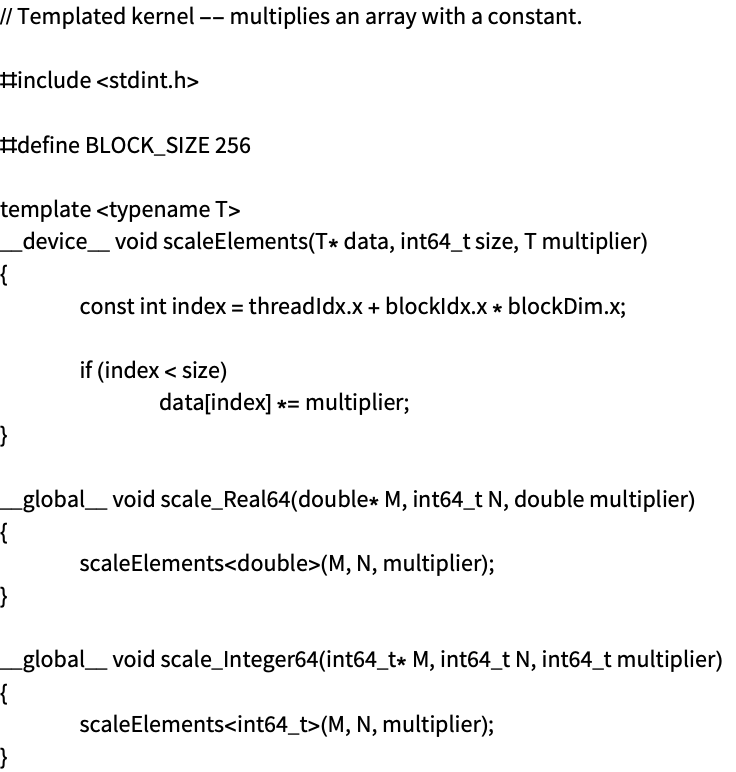
ExternalOperationを"Program"で使って,コードをExternalObjectにコンパイルする:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["Program", file]]compFuns["Functions"]data = GPUArray[NumericArray[Range[10], "Integer64"]];
compFuns["Functions"]["scale_Integer64"][data, 10, 42]Normal[data]格子とブロックの次元 (1)
CUDAカーネルがGPU上で実行されるとき,関数は複数のGPUプロセッサ上で並列に実行される.実際の呼出しでは,これらはブロックおよび格子の次元によって配列され,その内容は"BlockDimensions","BlockID",および"ThreadID"の組込み関数に反映される.
各データ点の計算された位置を配列に格納することにより,プロセッサの設定を探索する関数をコンパイルする:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, Cast[id, "Integer64"]]
	];
	]
]];len = 10;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];gpuFun[data, len]次は,配列が想定された方法でどのように充填されているかを示す:
Normal[data]len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];gpuFun[data, len]Take[Normal[data], -10]より大きいデータを生成し関数を実行する.ただし256スレッドを持つブロック1つだけが実際に使われるように格子とブロックの次元を設定する:
len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len, "GridDimensions" -> 1, "BlockDimensions" -> 256]Take[Normal[data], 10]しかしデータの最後の部分は,格子とブロックの次元が設定されなかったために充填されていない:
Take[Normal[data], -10]格子およびブロックの組込み関数 (1)
CUDAカーネルがGPU上で実行されるとき,関数は複数のGPUプロセッサ上で並列に実行される.実際の呼出しでは,これらは格子およびブロックの次元によって設定され,その内容は"BlockDimensions","BlockID",および"ThreadID"の組込み関数に反映される.
スレッドのIDを配列に格納することにより,プロセッサの設定を探索する関数をコンパイルする:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, Cast[LibraryFunction["ThreadID.x"][], "Integer64"]]
	];
	]
]];len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len]以下は256個のスレッドが使われたことを示している(デフォルト設定):
Take[Normal[data], 500]それぞれのブロックで,格子とブロックの次元をわずか32スレッドに設定する:
len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len, "GridDimensions" -> Quotient[len, 32], "BlockDimensions" -> 32]Take[Normal[data], 500]ホスト関数とプログラム (4)
CUDAプログラミングでは,ホスト(通常はCPU)上で実行されるコードも含まれ,このコードがGPU上でCUDAカーネルを起動する役割を果たす.この機能は,入力がCUDA C++である場合に,ExternalOperationの"HostFunction"および"HostProgram"によってサポートされる.なお,これらは純粋なCUDAカーネルではなく,ホスト上で実行されるコードである.
code = "#include \"WolframLibrary.h\"
#include <cuda_runtime.h>

__global__ void addKernel(double* out, const double* in, int n)
{
	int id = blockDim.x * blockIdx.x + threadIdx.x;
	if (id < n)
		out[id] = in[id] + 1.0;
}

extern \"C\" DLLEXPORT int runAdd(double* out, const double* in, int n)
{
	double *d_in, *d_out;
	cudaMalloc((void**)&d_in, n * sizeof(double));
	cudaMalloc((void**)&d_out, n * sizeof(double));
	cudaMemcpy(d_in, in, n * sizeof(double), cudaMemcpyHostToDevice);
	addKernel<<<(n + 255) / 256, 256>>>(d_out, d_in, n);
	cudaMemcpy(out, d_out, n * sizeof(double), cudaMemcpyDeviceToHost);
	cudaFree(d_in);
	cudaFree(d_out);
	return 0;
}";hostFun = ExternalEvaluate["CUDA", ExternalOperation["HostFunction", code]]このコードは,ホスト上に保存されたデータを想定して書かれており,ここで作成されるNumericArrayオブジェクトを渡すことで行うことができる:
dataIn = NumericArray[Range[10], "Real64"];
dataOut = NumericArray[ConstantArray[0, 10], "Real64"];hostFun[dataOut, dataIn, Length[dataIn]]Normal[dataOut]ホストコードはファイルからロードすることができる.例えば,次はホスト上で実行できるC++コードのファイルである:
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "add_library.cu"}]];
FilePrint[file]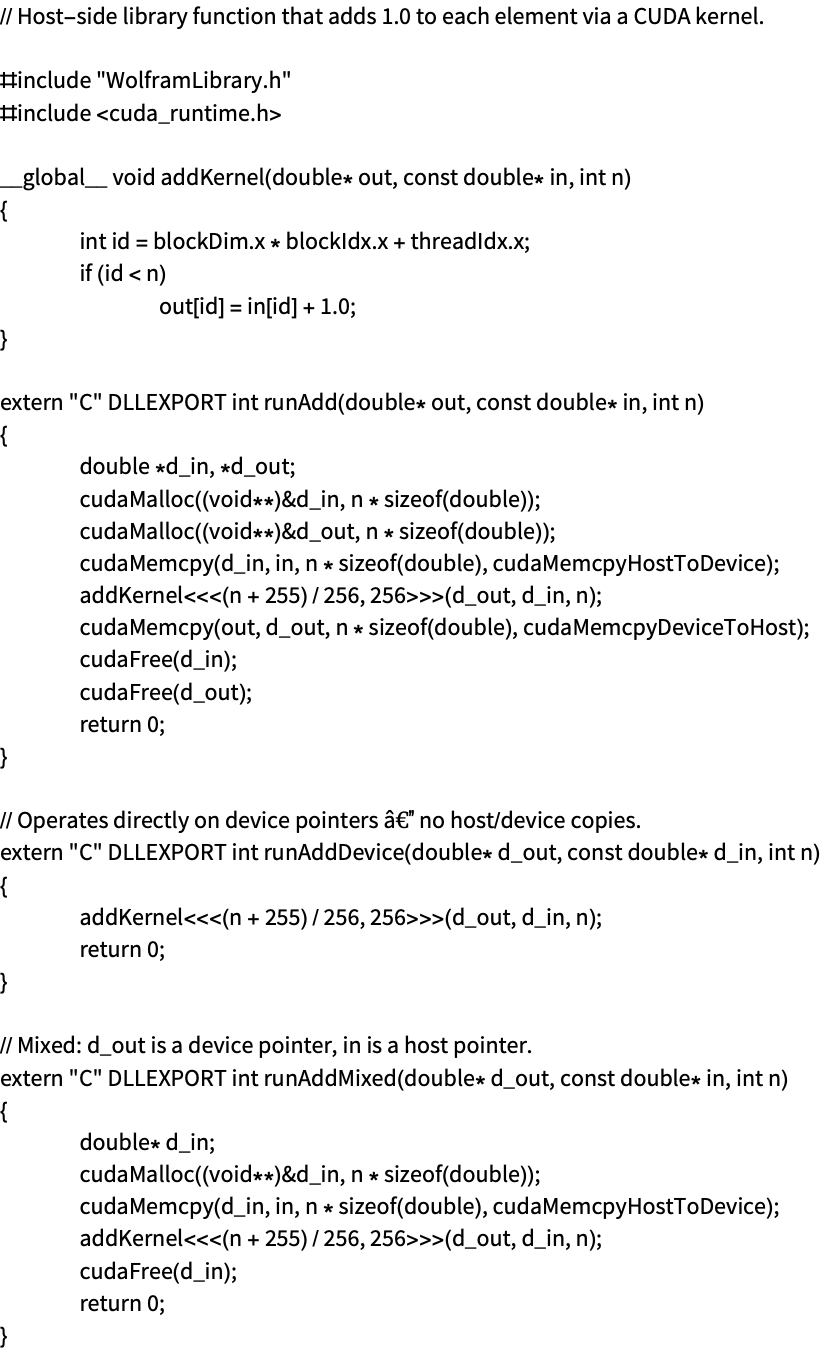
ExternalOperation "HostFunction"を使って関数runAddDeviceをコンパイルする:
hostFun = ExternalEvaluate["CUDA", ExternalOperation["HostFunction", file, "runAddDevice"]]この関数は,すでにデバイス上に存在するデータを取るように書かれており,これはGPUArrayを使って行われる.関数の引数として使うことのできるCPU上のデータがここで与えられる:
dataIn = GPUArray[NumericArray[Range[10], "Real64"]];
dataOut = GPUArray[NumericArray[ConstantArray[0, 10], "Real64"]];hostFun[dataOut, dataIn, 10]Normal[dataOut]入力コードの複数の関数をコンパイルすることも可能であり,これはExternalOperation "HostProgram"を使って行われる.
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "add_thrust_library.cu"}]];
FilePrint[file]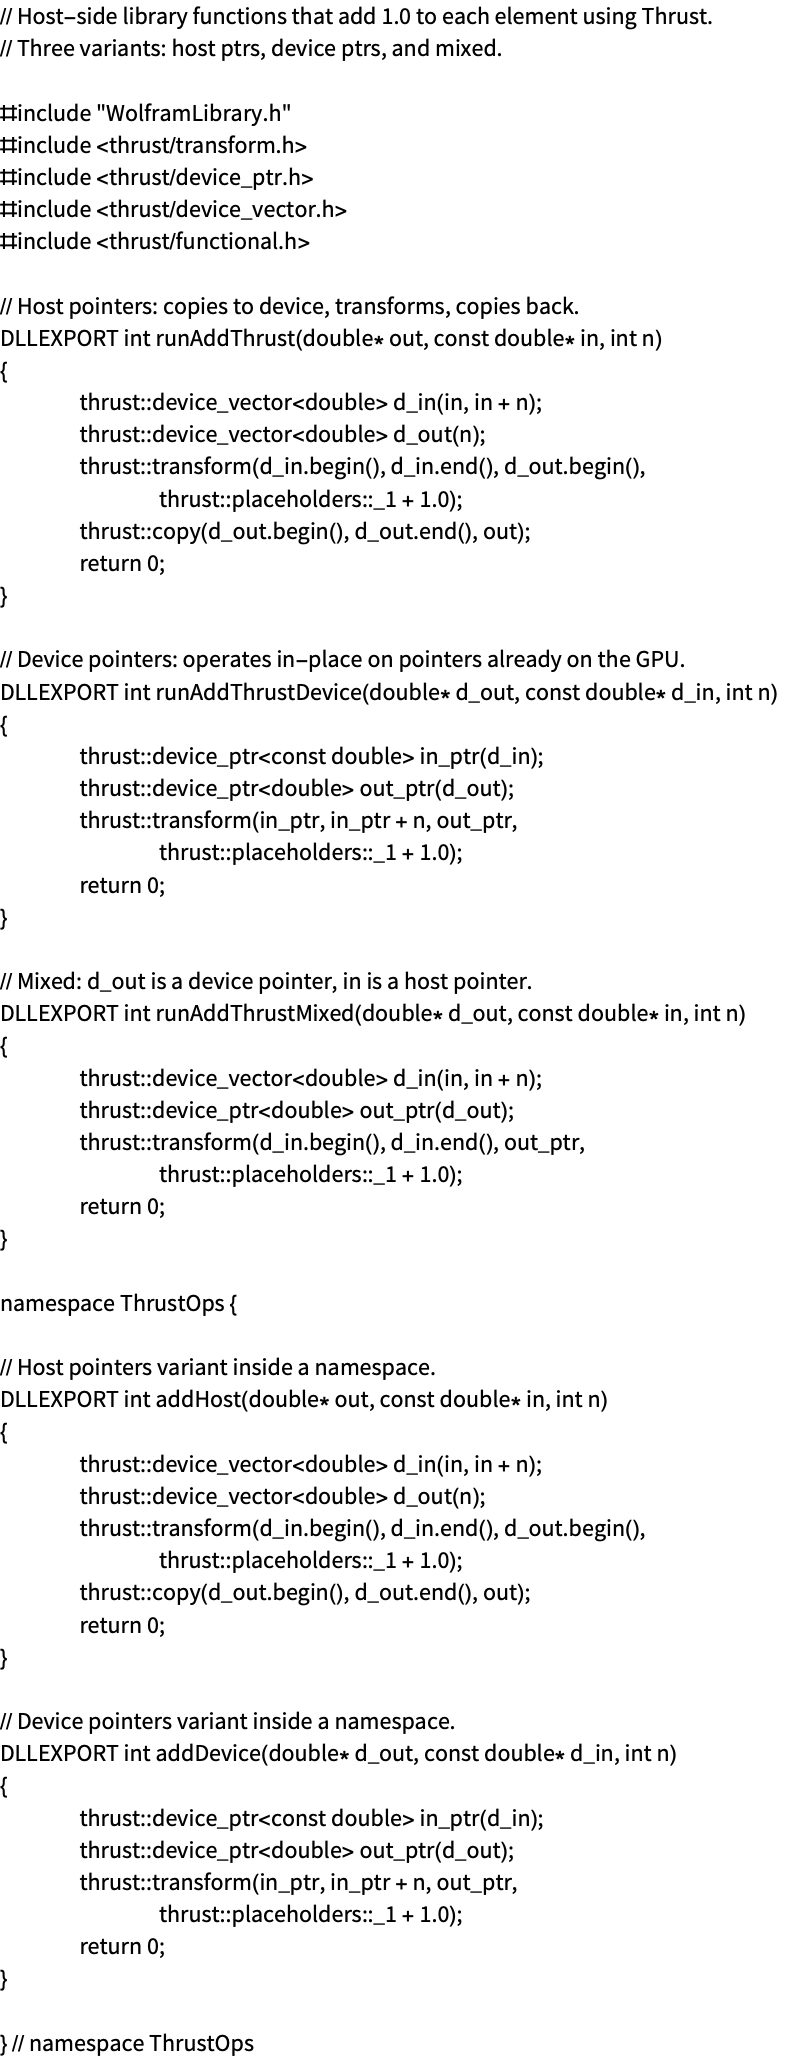
ExternalOperation "HostProgram"を使って,コードをExternalObjectにコンパイルする:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["HostProgram", file]]compFuns["Functions"]dataIn = NumericArray[Range[10], "Real64"];
dataOut = NumericArray[ConstantArray[0, 10], "Real64"];
compFuns["Functions"]["runAddThrust"][dataOut, dataIn, 10]Normal[dataOut]ホスト実行機能は,ホストまたはデバイス上に存在するデータを取ることができる.ホストデータはNumericArrayとして,デバイスデータはGPUArrayとして与えられる.システムはコードを解析し,引数がホストとデバイスのどちらにあることを想定しているかを自動的に判断する.しかし,LibraryFunctionDeclarationを使って関数の型シグネチャを指定することも可能である.
code = "#include \"WolframLibrary.h\"
#include <cuda_runtime.h>

__global__ void addKernel(double* out, const double* in, int n)
{
	int id = blockDim.x * blockIdx.x + threadIdx.x;
	if (id < n)
		out[id] = in[id] + 1.0;
}

extern \"C\" DLLEXPORT int runAdd(double* out, const double* in, int n)
{
	double *d_in, *d_out;
	cudaMalloc((void**)&d_in, n * sizeof(double));
	cudaMalloc((void**)&d_out, n * sizeof(double));
	cudaMemcpy(d_in, in, n * sizeof(double), cudaMemcpyHostToDevice);
	addKernel<<<(n + 255) / 256, 256>>>(d_out, d_in, n);
	cudaMemcpy(out, d_out, n * sizeof(double), cudaMemcpyDeviceToHost);
	cudaFree(d_in);
	cudaFree(d_out);
	return 0;
}";"runAdd"関数のシグネチャが与えられている.データ引数は"NumericArray"型を使うように与えられているので,ホスト上に存在するデータとして指定される:
ExternalEvaluate["CUDA", ExternalOperation["HostFunction", code, LibraryFunctionDeclaration["runAdd", {"NumericArray"::["Real64", 1], "NumericArray"::["Real64", 1], "CInt"} -> "CInt"]]]