"CUDA(外部计算系统)" (外部计算系统)
更多信息
- 支持 CUDA 12.0 及以上版本。
- Wolfram 语言将自动使用已安装的 CUDA GPU. 如果无可用的 CUDA GPU,则 CUDA 计算将无法工作. 如需进行高级配置,请按照 CUDAProgramming 工作流程中的说明进行操作.
外部计算的用法
- ExternalEvaluate["CUDA",func] 用 Wolfram 编译器将函数 func t编译为 ExternalFunction,该函数表示一个可在 CUDA GPU 上运行的内核.
- ExternalEvaluate["CUDA",str] 使用 CUDA 工具链将一段 C++ 代码字符串编译为可在 CUDA GPU 上执行的 ExternalFunction.
- ExternalEvaluate["CUDA",file] 使用 CUDA 工具链将一个 C++ 代码文件编译为可在 CUDA GPU 上执行的 ExternalFunction.
- 编译后在 CUDA GPU 上运行的代码亦称为 CUDA 内核.
- 存储在 ExternalFunction 对象中的 CUDA 内核可通过向其传递参数来执行.
- 当 CUDA 内核在 GPU 上运行时,函数会在多个 GPU 处理器上并行执行,其执行方式由选项 "BlockDimensions" 和 "GridDimensions" 控制:
- 支持以下选项:
-
"BlockDimensions" Automatic 指定每个模块上线程的运行方式 "GridDimensions" Automatic 指定网格上模块的运行方式 - 对于 "BlockDimensions" 和 "GridDimensions",可能的设置包括:
-
Automatic 通过检查输入的大小来选择一个值 x 一维网格 {x,y} 二维网格 {x,y,z} 三维网格
Wolfram 语言数据类型
- 编译为 CUDA 的 Wolfram 语言函数要求参数具有表示标量与数组的低级类型.
-
"CArray"::[ty] GPUArray 存储在 GPU 上的数值数据数组 "CArray"::[ty] NumericArray 存储在 CPU 上的数值数据数组 "CArray"::[ty] ExternalObject 存储在 ExternalObject 中的数值数据数组 "Integer64","Integer32", etc. Integer 整型 "Real64","Real32", etc. Real 实数类型 "ComplexReal32","ComplexReal64",etc. Complex 复数类型 - 由类型组成的、被编译为 CUDA 的 Wolfram 语言函数所使用的类型,与 Wolfram 编译器所使用的类型相同.
C++ 数据类型
- 编译为 CUDA 的 C++ 代码要求参数具有表示标量与数组的低级类型.
-
ty* GPUArray 存储在 GPU 上的数值数据数组 ty* NumericArray 存储在 CPU 上的数值数据数组 ty* ExternalObject 存储在 ExternalObject 中的数值数据数组 int, long, etc. Integer 整型 double,float, etc. Real 实数类型
支持的外部操作
- ExternalOperation["Function","code"] 将 Wolfram 语言或 C++ 代码编译为一个 ExternalFunction,该函数表示一个可在 CUDA GPU 上运行的内核.
- ExternalOperation["Program","code"] 将 Wolfram 语言或 C++ 代码编译为包含多个可在 CUDA GPU 上执行的外部函数对象的外部对象.
- ExternalOperation["HostFunction","code"] 将 C++ 代码编译为一个 ExternalFunction,该函数表示可在主机(通常是 CPU)上运行的主机代码.
- ExternalOperation["HostProgram","code"] 将 C++ 代码编译为一个外部对象,该对象包含多个外部函数对象,这些对象表示可在主机(通常是 CPU)上运行的主机代码.
范例
打开所有单元 关闭所有单元基本范例 (4)
将 Wolfram 语言代码编译为包含可在 CUDA GPU 上执行的 CUDA 内核的 ExternalFunction:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"::["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 5]
	];
	]
	]]
使用 GPUArray 将数据存储在 GPU 上,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Integer64"]];gpuFun[data, 10]Normal[data]将 C++ 代码编译为包含可在 CUDA GPU 上执行的 CUDA 内核的 ExternalFunction:
code = "#include \"WolframLibrary.h\"
__global__ void addFun(double *x, mint N) {
    const int tid =  blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < N) {
        x[tid] = x[tid] + 5;
    }
}";
gpuFun = ExternalEvaluate["CUDA", code]
使用 GPUArray 将数据存储在 GPU 上,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "increment_kernel.cu"}]];
FilePrint[file]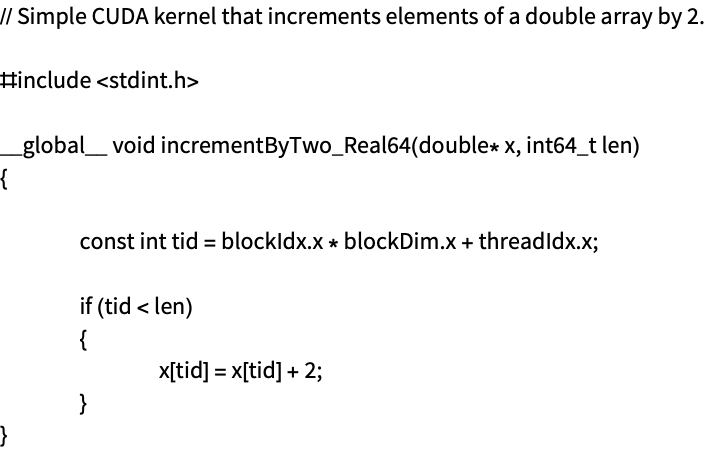
将文件中的 C++ 代码编译为包含可在 CUDA GPU 上执行的 CUDA 内核的 ExternalFunction:
gpuFun = ExternalEvaluate["CUDA", file]使用 GPUArray 将数据存储在 GPU 上,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]session = StartExternalSession["CUDA"]在 ExternalEvaluate 中使用外部会话,将 Wolfram 语言代码编译成一个 ExternalFunction,其中包含可在 CUDA GPU 上执行的 CUDA 内核:
gpuFun = ExternalEvaluate[session, Function[{Typed[x, "CArray"::["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 5]
	];
	]
	]]
使用 GPUArray 将数据存储在 GPU 上,这些数据可用作 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Integer64"]];gpuFun[data, 10]Normal[data]启动外部会话有助于获取有关 CUDA 安装问题的信息. 此外,CUDAProgramming 工作流程中的说明也相当有用.
范围 (11)
Wolfram 语言代码 (1)
将在 CUDA GPU 上执行的 Wolfram 语言代码:
func = Function[{Typed[x, "CArray"::["Real64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, FromRawPointer[ x, id] + 2]
	];
	]
	];
可通过 ExternalOperation 的 "Function" 模式进行编译:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", func]]使用 GPUArray 将数据存储在 GPU 上,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]可通过 FunctionDeclaration 提供额外的代码声明:
decl = FunctionDeclaration[increment, Typed[{"Real64"} -> "Real64"]@Function[arg, arg + 1]];func = Function[{Typed[x, "CArray"::["Real64"]], Typed[n, "MachineInteger"]},
Module[{id},
id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
If[id < n,
ToRawPointer[ x, id, increment[FromRawPointer[ x, id]]]
];
]
];可通过 ExternalOperation 的 "Function" 模式,同时使用声明和函数进行编译:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", decl, func]]data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]data//NormalC++ 代码 (4)
code = "#include \"WolframLibrary.h\"
__global__ void addFun(double *x, mint N) {
    const int tid =  blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < N) {
        x[tid] = x[tid] + 5;
    }
}";
可通过 ExternalOperation 的 "Function" 模式进行编译:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", code]]使用 GPUArray 在 GPU 上存储数据,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "increment_kernel.cu"}]];
FilePrint[file]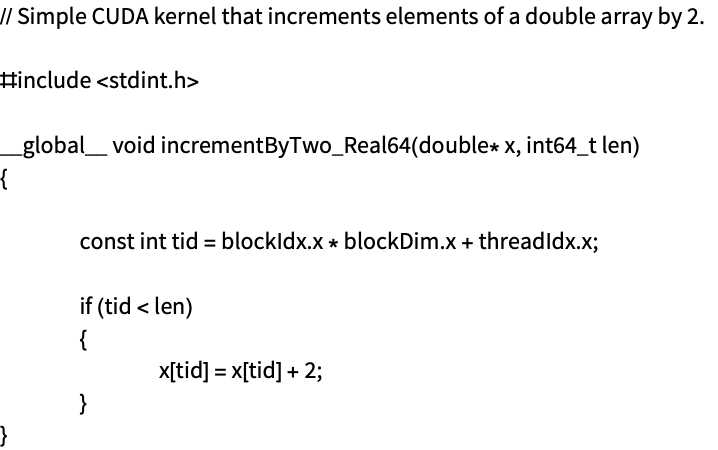
可通过 ExternalOperation 的 "Function" 模式进行编译:
gpuFun = ExternalEvaluate["CUDA", ExternalOperation["Function", file]]使用 GPUArray 在 GPU 上存储数据,以作为 CUDA 代码的参数:
data = GPUArray[NumericArray[Range[10], "Real64"]];gpuFun[data, 10]Normal[data]一个包含两个可在 GPU 上执行的函数的 C++ 代码文件:
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "arithmetic_kernels.cu"}]];
FilePrint[file]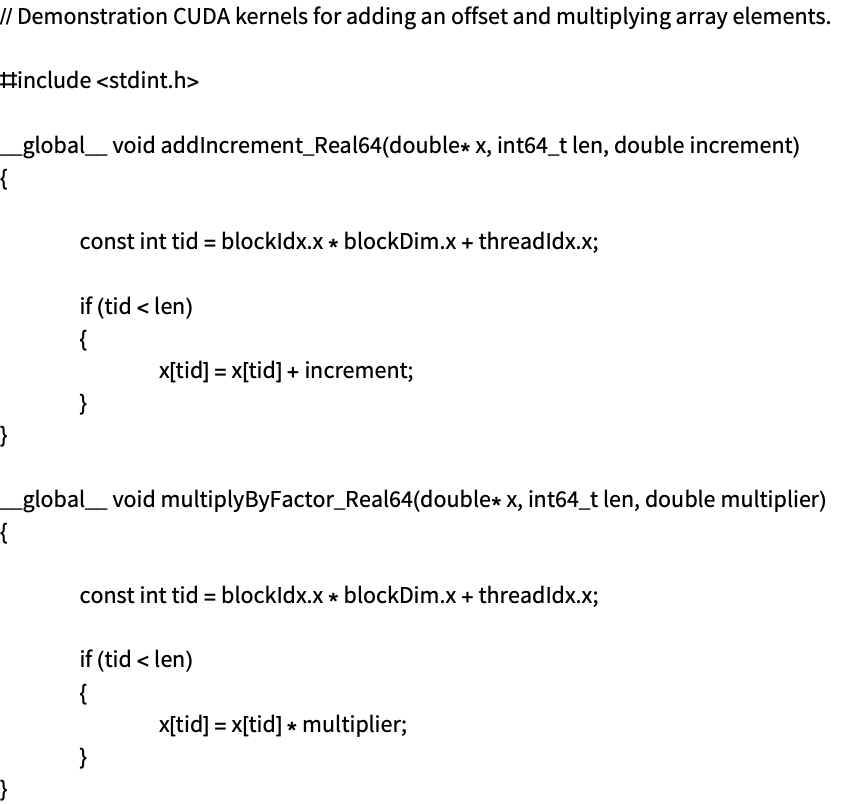
使用 ExternalOperation 的 "Program" 模式将代码编译为 ExternalObject:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["Program", file]]compFuns["Functions"]data = GPUArray[NumericArray[Range[10], "Real64"]];
compFuns["Functions"]["addIncrement_Real64"][data, 10, 42]Normal[data]data = GPUArray[NumericArray[Range[10], "Real64"]];
compFuns["Functions"]["multiplyByFactor_Real64"][data, 10, 42]Normal[data]compFuns["FunctionsByMangledName"]file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "scale_kernel.cu"}]];
FilePrint[file]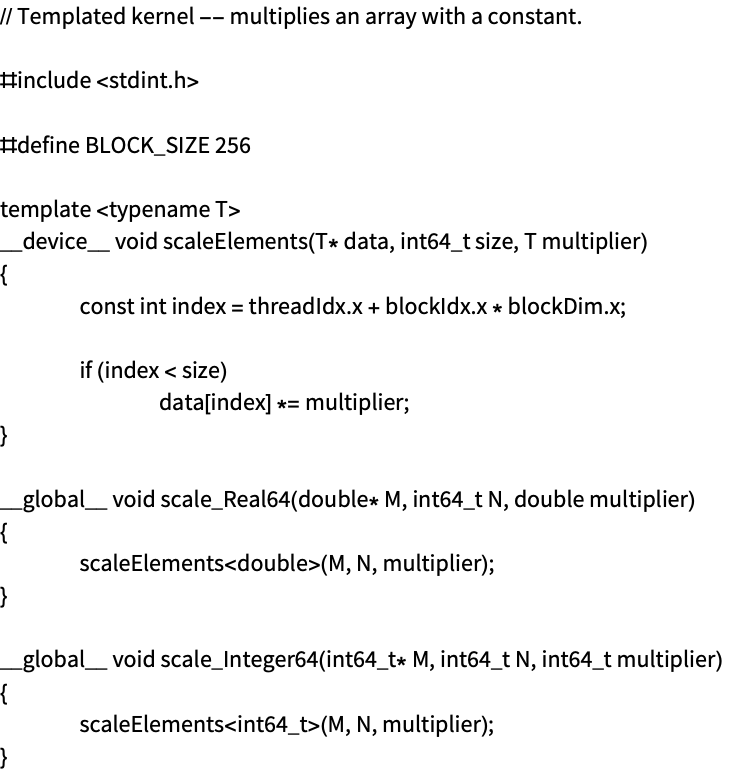
使用 ExternalOperation 的 "Program" 模式将代码编译为 ExternalObject:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["Program", file]]compFuns["Functions"]data = GPUArray[NumericArray[Range[10], "Integer64"]];
compFuns["Functions"]["scale_Integer64"][data, 10, 42]Normal[data]网格与线程块的大小 (1)
当 CUDA 内核在 GPU 上运行时,函数会在多个 GPU 处理器上并行执行. 这些是实际调用时按线程块和网格的大小进行组织的. 在代码中,通过 "BlockDimensions"、"BlockID" 和 "ThreadID" 这些内置函数来设定.
编译一个函数,通过将每个数据点的计算位置存入数组来探查处理器的设置:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"::["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, Cast[id, "Integer64"]]
	];
	]
]];len = 10;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];gpuFun[data, len]Normal[data]len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];gpuFun[data, len]Take[Normal[data], -10]生成大型数据集并执行该函数,但设置网格和线程块的大小,使得实际上只使用一个包含 256 个线程的块:
len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len, "GridDimensions" -> 1, "BlockDimensions" -> 256]Take[Normal[data], 10]Take[Normal[data], -10]网格与线程块内部的函数 (1)
当 CUDA 内核在 GPU 上运行时,函数会在多个 GPU 处理器上并行执行. 其设置方式由网格和块的维度决定,并反映在 "BlockDimensions"、"BlockID" 以及 "ThreadID" 这些内置函数中.
编译一个函数,通过将线程 ID 存入数组来探查处理器的设置:
gpuFun = ExternalEvaluate["CUDA", Function[{Typed[x, "CArray"["Integer64"]], Typed[n, "MachineInteger"]},
	Module[{id},
	id = LibraryFunction["BlockDimensions.x"][] * LibraryFunction["BlockID.x"][] + LibraryFunction["ThreadID.x"][];
	If[id < n,
	ToRawPointer[ x, id, Cast[LibraryFunction["ThreadID.x"][], "Integer64"]]
	];
	]
]];len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len]Take[Normal[data], 500]len = 10000;
data = GPUArray[NumericArray[ConstantArray[0, len], "Integer64"]];
gpuFun[data, len, "GridDimensions" -> Quotient[len, 32], "BlockDimensions" -> 32]Take[Normal[data], 500]主机函数和程序 (4)
CUDA 编程还涉及在主机(通常是 CPU)上执行的代码,这些代码负责在 GPU 上启动 CUDA 内核. 当输入为 CUDA C++ 时,可通过 ExternalOperation 与 "HostFunction" 和 "HostProgram" 使用这些代码. 注意,这些不是纯粹的 CUDA 内核,而是在主机上执行的代码.
code = "#include \"WolframLibrary.h\"
#include <cuda_runtime.h>

__global__ void addKernel(double* out, const double* in, int n)
{
	int id = blockDim.x * blockIdx.x + threadIdx.x;
	if (id < n)
		out[id] = in[id] + 1.0;
}

extern \"C\" DLLEXPORT int runAdd(double* out, const double* in, int n)
{
	double *d_in, *d_out;
	cudaMalloc((void**)&d_in, n * sizeof(double));
	cudaMalloc((void**)&d_out, n * sizeof(double));
	cudaMemcpy(d_in, in, n * sizeof(double), cudaMemcpyHostToDevice);
	addKernel<<<(n + 255) / 256, 256>>>(d_out, d_in, n);
	cudaMemcpy(out, d_out, n * sizeof(double), cudaMemcpyDeviceToHost);
	cudaFree(d_in);
	cudaFree(d_out);
	return 0;
}";hostFun = ExternalEvaluate["CUDA", ExternalOperation["HostFunction", code]]该代码预期数据存储在主机上,这可以通过传递在此处创建的 NumericArray 对象来实现:
dataIn = NumericArray[Range[10], "Real64"];
dataOut = NumericArray[ConstantArray[0, 10], "Real64"];hostFun[dataOut, dataIn, Length[dataIn]]Normal[dataOut]主机代码也可以从文件加载. 例如,这是一个可以在主机上执行的 C++ 代码文件:
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "add_library.cu"}]];
FilePrint[file]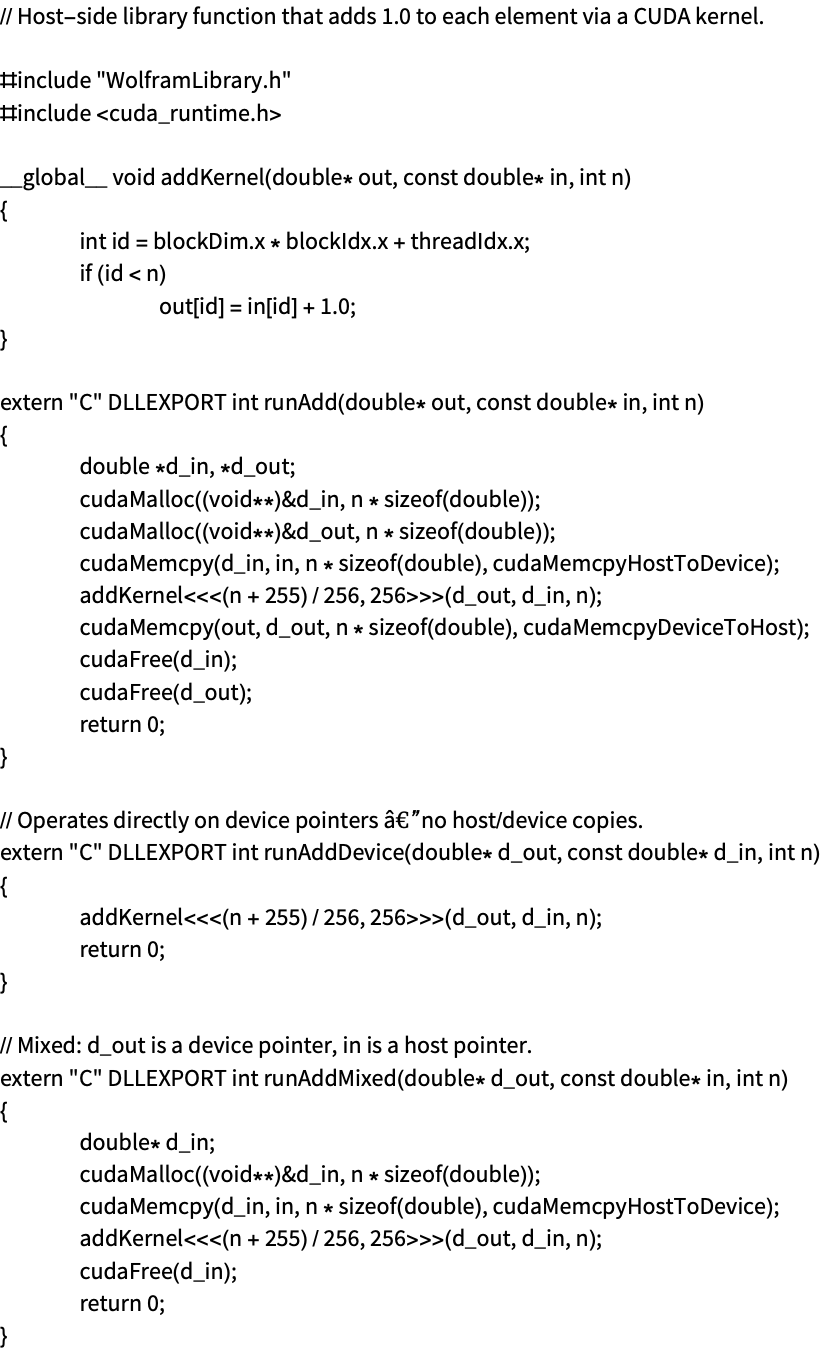
将函数 runAddDevice 和 ExternalOperation "HostFunction" 一起编译:
hostFun = ExternalEvaluate["CUDA", ExternalOperation["HostFunction", file, "runAddDevice"]]此函数用于读取 CUDA 设备上已有的数据,可通过使用 GPUArray 来实现. 下面提供了可在 GPU 上用作参数函数的数据:
dataIn = GPUArray[NumericArray[Range[10], "Real64"]];
dataOut = GPUArray[NumericArray[ConstantArray[0, 10], "Real64"]];hostFun[dataOut, dataIn, 10]Normal[dataOut]也可以在输入代码中编译多个函数,可通过 ExternalOperation "HostProgram" 来实现.
file = File[FileNameJoin[{PacletObject["CUDALink"]["Location"], "CUDACode", "add_thrust_library.cu"}]];
FilePrint[file]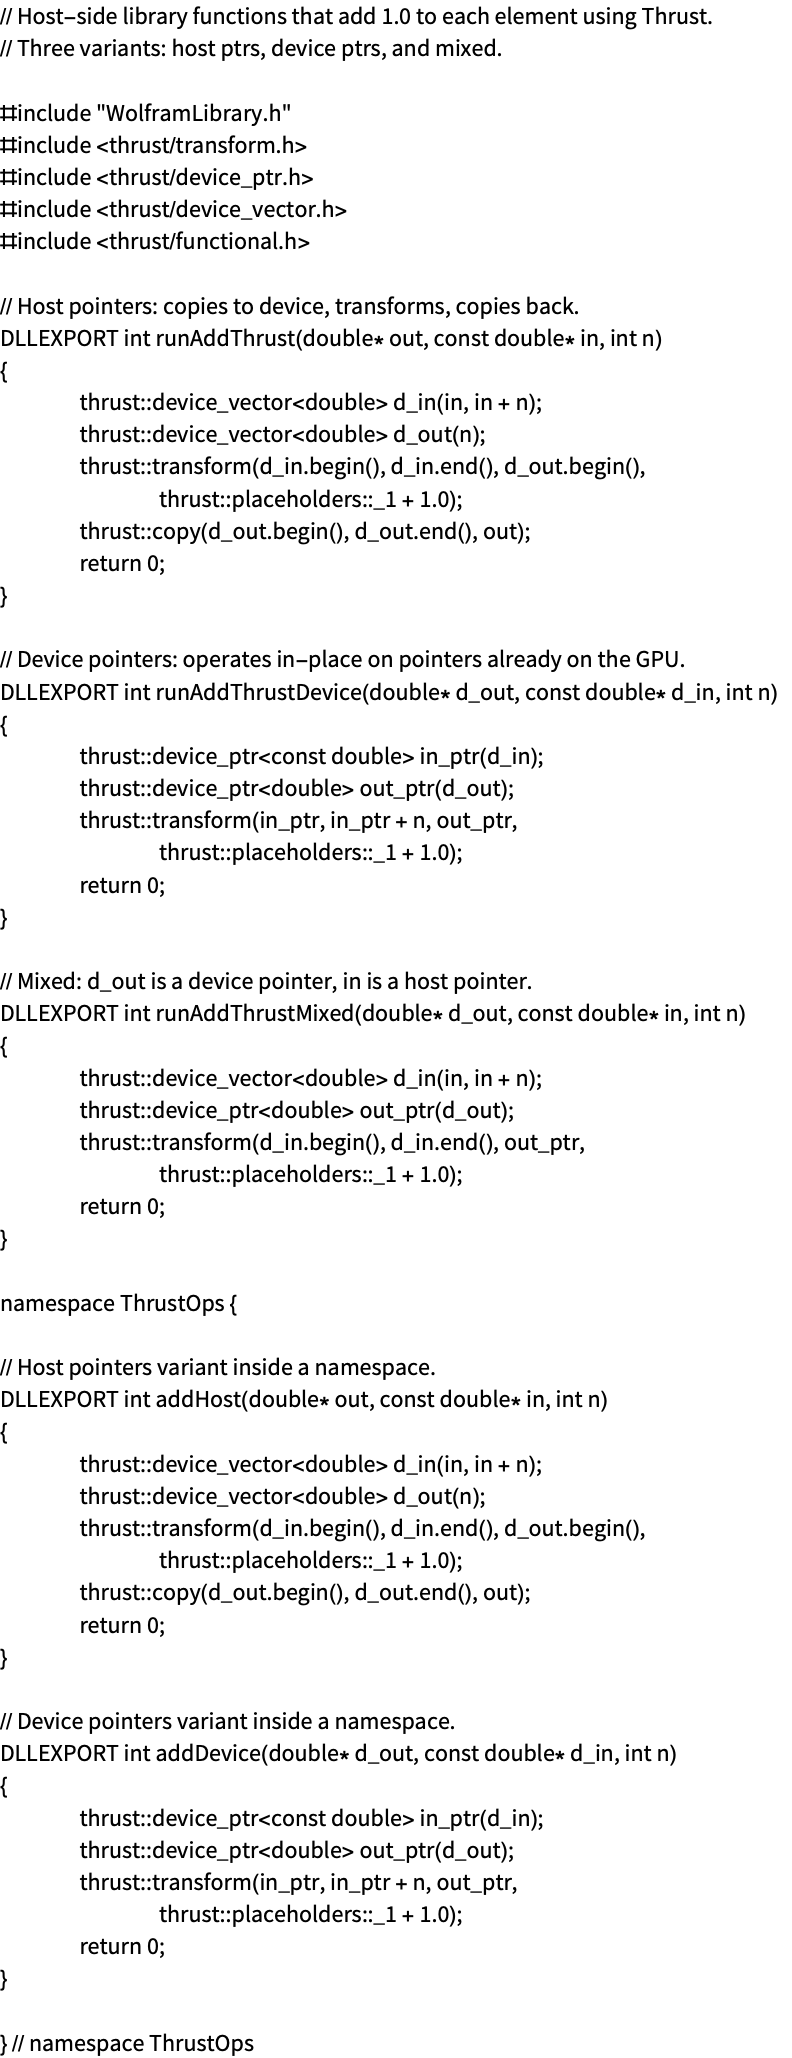
用 ExternalOperation "HostProgram" 将代码编译为 ExternalObject:
compFuns = ExternalEvaluate["CUDA", ExternalOperation["HostProgram", file]]compFuns["Functions"]dataIn = NumericArray[Range[10], "Real64"];
dataOut = NumericArray[ConstantArray[0, 10], "Real64"];
compFuns["Functions"]["runAddThrust"][dataOut, dataIn, 10]Normal[dataOut]主机执行功能可读取位于主机或设备上的数据. 主机数据以 NumericArray 的形式给出,而设备数据以 GPUArray 的形式给出. 系统会分析代码,自动判断参数位于主机上,还是在设备上. 然而,也可以使用 LibraryFunctionDeclaration 来指定函数的类型签名:
code = "#include \"WolframLibrary.h\"
#include <cuda_runtime.h>

__global__ void addKernel(double* out, const double* in, int n)
{
	int id = blockDim.x * blockIdx.x + threadIdx.x;
	if (id < n)
		out[id] = in[id] + 1.0;
}

extern \"C\" DLLEXPORT int runAdd(double* out, const double* in, int n)
{
	double *d_in, *d_out;
	cudaMalloc((void**)&d_in, n * sizeof(double));
	cudaMalloc((void**)&d_out, n * sizeof(double));
	cudaMemcpy(d_in, in, n * sizeof(double), cudaMemcpyHostToDevice);
	addKernel<<<(n + 255) / 256, 256>>>(d_out, d_in, n);
	cudaMemcpy(out, d_out, n * sizeof(double), cudaMemcpyDeviceToHost);
	cudaFree(d_in);
	cudaFree(d_out);
	return 0;
}";
函数 "runAdd" 的签名已给定. 由于数据参数被指定为 "NumericArray" 类型,因此它们被指定为驻留在主机上的数据:
ExternalEvaluate["CUDA", ExternalOperation["HostFunction", code, LibraryFunctionDeclaration["runAdd", {"NumericArray"::["Real64", 1], "NumericArray"::["Real64", 1], "CInt"} -> "CInt"]]]