"Agglomerate" (機械学習メソッド)
"Agglomerate" (機械学習メソッド)
- FindClusters,ClusterClassify,ClusteringComponentsのメソッド
- 階層的凝縮クラスタリング法を使って,データを類似要素のクラスタに分割する.
詳細とサブオプション
- "Agglomerate"は階層的クラスタリング法である."Agglomerate"はクラスタ密度が似通ってい等方性の場合にはうまくいくが,クラスタが大きかったり,大きさが違ったりする場合はうまくいかないことがある.また,このアルゴリズムは非類似度関数の選択に敏感である.
- 次は,"Agglomerate"法をトイデータ集合に適用した結果である.
-
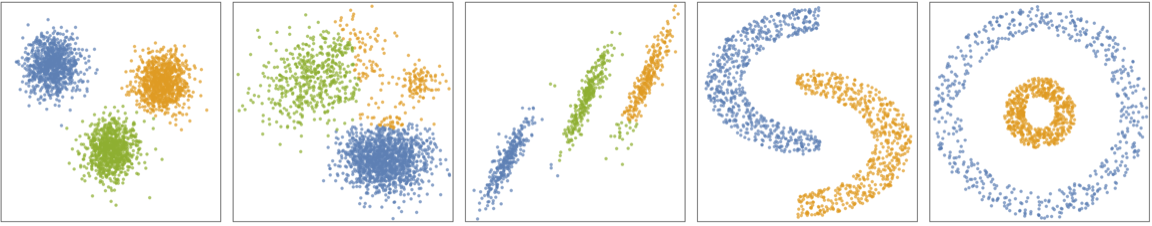
- "Agglomerate"はクラスタの階層を構築する.このメソッドは,操作のはじめに各データ点をクラスタに割り当て,階層を上がりなが類似するクラスタを繰り返し結合する.各反復で最も類似度が高いクラスタが結合される.指定のクラスタ数に達すると結合は行われなく.クラス多数が指定されていない場合は,すべてのクラスタペアが指定された類似度の閾値を上回ったときに結合が行われなくなる.
- 次のサブオプションを与えることができる.
-
ClusterDissimilarityFunction "Single" クラスタ非類似度のリンケージ - クラスタの非類似度は,サブオプションのClusterDissimilarityFunctionで指定可能な結合関数で定義される.ClusterDissimilarityFunctionf の可能な設定には以下がある.
-
"Single" クラスタの最近点間の距離 "Complete" クラスタの最遠点間の距離 "Average" クラスタの点の間の平均距離 "Centroid" クラスタの平均間の距離 "Median" クラスタの中央値間の距離 "Ward" クラスタの点の間の平均平方距離 "WeightedAverage" 加重平均クラスタ間非類似度 f 純関数 - "Complete"結合は,比較的コンパクトで離れた標準サイズのクラスタを見付ける傾向がある"Average","Centroid","Median","Ward" とは対照的に,クラスタを破壊する傾向がある.
例題
すべて開く すべて閉じる例 (3)
"Agglomerate"法を使って近くの値のクラスタを求める:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25}, Method -> "Agglomerate"]"Agglomerate"クラスタリング法を使って,近くの値の4つのクラスタを求める:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25}, UpTo@4, Method -> "Agglomerate"]"Agglomerate"法を使って,色のリスト中のクラスタを得る:
colors = RandomColor[100];
FindClusters[colors, Method -> "Agglomerate"]"Agglomerate"法を使って画像の2つのクラスタを識別するClassifierFunctionを作る:
images = {[image], [image], [image], [image], [image], [image], [image], [image], [image]};c = ClusterClassify[images, UpTo@2, Method -> "Agglomerate"]c[images]GatherBy[images, c]オプション (2)
"ClusterDissimilarityFunction" (2)
SeedRandom[1234];
ns = 100;
cov = {{.2, 0 }, {0 , .2}};
data = Join[
	RandomVariate[MultinormalDistribution[{3, 1}, cov], ns],
	RandomVariate[MultinormalDistribution[{1, 3}, cov], ns],
	RandomVariate[MultinormalDistribution[{1, 1}, cov], ns],
	RandomVariate[MultinormalDistribution[{3, 3}, cov], ns]
];異なるClusterDissimilarityFunctionを使って近くのクラスタを得る:
Grid[{Table[ListPlot[FindClusters[data, UpTo@4, Method -> {"Agglomerate", ClusterDissimilarityFunction -> s}], PlotStyle -> PointSize[Medium]], {s, {"Single", "Complete", "Average", "Ward" }}]}, Frame -> All]"Agglomerate"法を使って,色のリスト中で近いクラスタを得る:
colors = RandomColor[50];
FindClusters[colors, Method -> "Agglomerate"]
別のクラスタの非類似度を使って,色のリスト中で近いクラスタを得る:
table = Table[FindClusters[colors, Method -> {"Agglomerate", ClusterDissimilarityFunction -> p}], {p, {"Centroid", "Single", "Ward"}}];
Grid[{table}, Frame -> All]
 An Elementary Introduction to the Wolfram Language