"NeighborhoodContraction" (机器学习方法)
"NeighborhoodContraction" (机器学习方法)
- 用于 FindClusters、ClusterClassify 和 ClusteringComponents 的方法.
- 使用 "NeighborhoodContraction" 聚类算法将数据划分为相似元素的聚类.
Details & Suboptions
- "NeighborhoodContraction" 是一种基于邻域的聚类方法. "NeighborhoodContraction" 适用于任意形状和大小的聚类,但是,当聚类密度不同或相互交织时,它可能会失效.
- 下图展示了将 "NeighborhoodContraction" 方法应用于玩具数据集的结果:
-
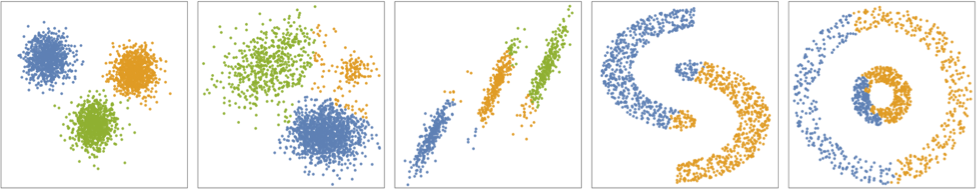
- "NeighborhoodContraction" 方法通过迭代将数据点向更高密度区域移动. 在此过程中,数据点倾向于收敛到不同的固定点,每个固定点代表一个聚类.
- 形式上,在每一步中,每个数据点
 被设置为其邻近点
 的平均值,
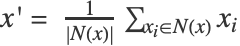 .
- 邻近点
 被定义为半径为 ϵ 的球体内的所有点. 算法重复进行更新,直到点不再移动;属于一个聚类的所有点随后都会收缩到一起(在一定容差范围内). 这个算法等同于 "MeanShift" 方法,但使用了不同的邻域定义.
- 可以给出以下子选项:
-
"NeighborhoodRadius" Automatic 半径 ϵ
范例
打开所有单元 关闭所有单元基本范例 (3)
使用 "NeighborhoodContraction" 聚类方法找到附近值的聚类:
FindClusters[{1, 2, 10, 12, 3, 1, 13, 25, 27, 28}, Method -> "NeighborhoodContraction"]使用 "NeighborhoodContraction" 方法在颜色列表上训练 ClassifierFunction:
SeedRandom[12];
colors = RandomColor[200];
c = ClusterClassify[colors, Method -> "NeighborhoodContraction"]GatherBy[colors, c]在二维正态分布的混合上训练 ClassifierFunction:
ns = 600;
Gaussiandata[ns_, mean_, cov_] :=
	BlockRandom[RandomVariate[MultinormalDistribution[mean, cov], ns]];

data = Join[Gaussiandata[1200, {0, 0},   {{1, 0 }, {0 , 1}}], Gaussiandata[600, {1.5, 4.5},   {{1, 0 }, {0 , 1}}] ,
	Gaussiandata[300, {-3, 5}, {{2, 1 / 2 }, {1 / 2 , 2}}]];

cl = ClusterClassify[data, Method -> "NeighborhoodContraction"]decision = cl[data];
classes = Information[cl, "Classes"];ListPlot[Pick[data, decision, #]& /@ classes]选项 (3)
DistanceFunction (2)
SeedRandom[12];
colors = RandomColor[200]
通过指定 DistanceFunction 选项查找聚类:
FindClusters[colors, Method -> "NeighborhoodContraction", DistanceFunction -> ColorDistance]ns = 600;
Gaussiandata[ns_, mean_, cov_] :=
BlockRandom[RandomVariate[MultinormalDistribution[mean, cov], ns]];
data = Join[Gaussiandata[1200, {0, 0}, {{1, 0 }, {0 , 1}}], Gaussiandata[600, {1.5, 4.5}, {{1, 0 }, {0 , 1}}] ,
Gaussiandata[300, {-2, 5}, {{2, 1 / 2 }, {1 / 2 , 2}}]];通过指定不同的 DistanceFunction 选项来查找不同的聚类结构:
Grid[{Table[ListPlot[FindClusters[data, Method -> {"NeighborhoodContraction"}, DistanceFunction -> df],
Frame -> True, Axes -> False, FrameTicks -> None, AspectRatio -> 1, PlotStyle -> Directive[PointSize[0.03]]], {df, {EuclideanDistance, ChessboardDistance, ManhattanDistance}}]
}]"NeighborhoodRadius" (1)
ns = 600;
Gaussiandata[ns_, mean_, cov_] :=
	BlockRandom[RandomVariate[MultinormalDistribution[mean, cov], ns]];

data = Join[Gaussiandata[1200, {0, 0},   {{1, 0 }, {0 , 1}}], Gaussiandata[600, {1.5, 4.5},   {{1, 0 }, {0 , 1}}] ,
	Gaussiandata[300, {-2, 5}, {{2, 1 / 2 }, {1 / 2 , 2}}]];
通过指定不同的 "NeighborhoodRadius" 子选项来找到不同的聚类结构:
Grid[{Table[ListPlot[FindClusters[data, Method -> {"NeighborhoodContraction", "NeighborhoodRadius" -> nr}],
	Frame -> True, Axes -> False, FrameTicks -> None, AspectRatio -> 1, PlotStyle -> Directive[PointSize[0.03]]], {nr, {.1, .2, .4}}]
	}]
 An Elementary Introduction to the Wolfram Language