



FindDistributionParameters
FindDistributionParameters[data,dist]
data から分布 dist の母数推定を求める.
FindDistributionParameters[data,dist,{{p,p0},{q,q0},…}]
初期値が p0, q0, …の母数 p, q, …を求める.
詳細とオプション
- FindDistributionParametersは dist 中の母数のための置換規則のリストを返す.
- data は与えられた分布 dist からの可能な結果のリストでなければならない.
- 分布 dist は任意の一変量あるいは多変量のパラメトリック分布,あるいは母数が不明の派生分布でよい.
- 使用可能なオプション
-
AccuracyGoal Automatic 目標確度 ParameterEstimator "MaximumLikelihood" 使用する母数推定量 PrecisionGoal Automatic 目標精度 WorkingPrecision Automatic 内部計算に使用する精度 - ParameterEstimatorでは次の基本的な設定値が使用できる.
-
"MaximumLikelihood" 対数尤度関数を最大化 "MethodOfMoments" 原点の周りのモーメントをマッチ "MethodOfCentralMoments" 中心モーメントをマッチ "MethodOfCumulants" キュムラントをマッチ "MethodOfFactorialMoments" 階乗モーメントをマッチ - 最尤法は対数尤度関数
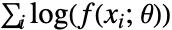 を最大化しようとする.ただし,
 は分布母数であり
 は分布の確率密度関数である.
- モーメント法は
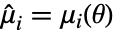 ,
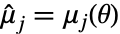 ,
 を解く.ただし,
 は

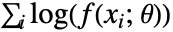 次サンプルモーメントであり,
 は母数
 の分布の

 次モーメントである.
- モーメント法に基づく推定量は母数についてのすべての制約を満たさないことがある.
例題
すべて開く すべて閉じる例 (3)
ラプラス(Laplace)分布を仮定して母数の最尤推定量を求める:
FindDistributionParameters[{1.5, 2.8, 4.3, .5}, LaplaceDistribution[μ, σ]]FindDistributionParameters[{1.5, 2.8, 4.3, .5}, LaplaceDistribution[μ, σ], ParameterEstimator -> "MethodOfMoments"]data = RandomVariate[DirichletDistribution[{3, 4, 5}], 100];params = FindDistributionParameters[data, DirichletDistribution[{Subscript[α, 1], Subscript[α, 2], Subscript[α, 3]}]]Plot3D[PDF[DirichletDistribution[{Subscript[α, 1], Subscript[α, 2], Subscript[α, 3]}] /. params, {x, y}] - PDF[DirichletDistribution[{3, 4, 5}], {x, y}], {x, 0, 1}, {y, 0, 1}, PlotRange -> All]data = RandomVariate[LaplaceDistribution[Quantity[100, "Grams"], Quantity[500, "Milligrams"]], 100]FindDistributionParameters[data, LaplaceDistribution[m, s]]スコープ (15)
基本的な用法 (5)
bdata = {23, 16, 24, 17, 16, 17, 18, 17, 19, 23, 19, 13, 19, 18, 22, 21, 19, 22, 19, 23};FindDistributionParameters[bdata, BinomialDistribution[n, p]]FindDistributionParameters[bdata, BinomialDistribution[50, p]]FindDistributionParameters[bdata, BinomialDistribution[n, 2 / 5]]vals = RandomReal[ChiSquareDistribution[20], 1000];res = FindDistributionParameters[vals, ChiSquareDistribution[n]]データのヒストグラムと推定値の確率密度関数を比較することで適合度をチェックする:
Show[Histogram[vals, Automatic, "ProbabilityDensity"], Plot[PDF[ChiSquareDistribution[n] /. res, x], {x, 0, 50}]]DistributionFitTest[vals, ChiSquareDistribution[n] /. res, {"TestDataTable", All}]DistributionFitTest[vals, ChiSquareDistribution[n], {"TestDataTable", All}]data = RandomVariate[GeometricDistribution[.4], 100];phat = FindDistributionParameters[data, GeometricDistribution[p]]対数尤度関数をプロットし,解が最適であることを視覚的に確かめる:
Show[Plot[LogLikelihood[GeometricDistribution[p], data], {p, 0, 1}], Graphics[{PointSize[Large], Red, Point[{p, LogLikelihood[GeometricDistribution[p], data]} /. phat]}]]data = BlockRandom[SeedRandom[100];RandomVariate[WeibullDistribution[4, 5], 50]];cp = ContourPlot[LogLikelihood[WeibullDistribution[α, β], data], {α, 2, 6}, {β, 3, 8}]params = FindDistributionParameters[data, WeibullDistribution[α, β], {{α, 3}, {β, 5.5}}]Show[cp, Graphics[{PointSize[Large], Red, Point[{α, β} /. params]}]]data = RandomVariate[PoissonDistribution[20], 100];FindDistributionParameters[data, NormalDistribution[μ, σ]]FindDistributionParameters[data, NormalDistribution[μ, σ], WorkingPrecision -> 20]一変量パラメトリック分布 (2)
data = {0.8, 0.98, 0.66, 0.09, 0.03, 0.16, 0.88, 0.32, 0.56, 0.3, 0.82, 0.34, 0.93, 0.33, 0.25, 0.74, 0.3, 0.74, 0.16, 0.02};FindDistributionParameters[data, BetaDistribution[α, β]]data = {16, 1, 2, 5, 3, 5, 1, 6, 4, 14, 2, 9, 1, 1, 2, 2, 8, 1, 3, 1};param = FindDistributionParameters[data, LogSeriesDistribution[θ]]Plot[{CDF[LogSeriesDistribution[θ] /. param, x], CDF[EmpiricalDistribution[data], x]}, {x, 0, 20}, Exclusions -> None]多変量パラメトリック分布 (2)
mdata = RandomVariate[MultinomialDistribution[20, {1 / 3, 1 / 6, 1 / 10, 2 / 5}], 1000];FindDistributionParameters[mdata, MultinomialDistribution[n, {Subscript[p, 1], Subscript[p, 2], Subscript[p, 3], Subscript[p, 4]}]]data = RandomVariate[BinormalDistribution[{1, 2}, {1 / 3, 4}, 3 / 4], 1000];params = FindDistributionParameters[data, BinormalDistribution[{Subscript[μ, 1], Subscript[μ, 2]}, {Subscript[σ, 1], Subscript[σ, 2]}, ρ]]Table[Plot[PDF[NormalDistribution[Subscript[μ, i], Subscript[σ, i]] /. params, x], {x, Min[data[[All, i]]], Max[data[[All, i]]]}, PlotRange -> All], {i, 2}]//Row{{Subscript[σ, 1]^2, Subscript[σ, 1] Subscript[σ, 2] ρ}, {Subscript[σ, 1] Subscript[σ, 2] ρ, Subscript[σ, 2]^2}} /. params//MatrixForm派生分布 (6)
SeedRandom[1];
data = RandomVariate[TruncatedDistribution[{-1, 2}, NormalDistribution[1, 1 / 3]], 100];FindDistributionParameters[data, TruncatedDistribution[{min, max}, NormalDistribution[μ, σ]]]dist = ProbabilityDistribution[λ Exp[λ(1 - x)], {x, 1, Infinity}, Assumptions -> λ > 0]data = {1.4, 5.1, 1.7, 1.6, 1.1, 3.9, 2.2, 1.3, 2., 1.5};param = FindDistributionParameters[data, dist]Plot[LogLikelihood[dist, data], {λ, .1, 2}, Epilog -> {PointSize[Medium], Red, Point[{λ, LogLikelihood[dist, data]} /. param]}]data = RandomVariate[ProductDistribution[BetaDistribution[2, 3], LaplaceDistribution[10, 1]], 100];FindDistributionParameters[data, ProductDistribution[BetaDistribution[α, β], LaplaceDistribution[μ, σ]]]data = RandomVariate[CopulaDistribution[{"Frank", 1 / 2}, {GammaDistribution[2, 3], ChiSquareDistribution[10]}], 100];FindDistributionParameters[data, CopulaDistribution[{"Frank", c}, {GammaDistribution[α, β], ChiSquareDistribution[n]}]]data = RandomVariate[MixtureDistribution[{2 / 3, 1 / 3}, {GammaDistribution[2, 3], NormalDistribution[1, 1 / 4]}], 100];𝒟1 = MixtureDistribution[{p, 1 - p}, {GammaDistribution[α, β], NormalDistribution[μ, σ]}];param1 = FindDistributionParameters[data, 𝒟1]//Quiet𝒟2 = MixtureDistribution[{p, 1 - p}, {GammaDistribution[2, 3], NormalDistribution[1, 1 / 4]}];param2 = FindDistributionParameters[data, 𝒟2]Show[Histogram[data, {0, 20, .5}, "PDF"], Plot[{PDF[𝒟1 /. param1, x], PDF[𝒟2 /. param2, x]}, {x, 0, 20}, PlotRange -> All, PlotLegends -> {"𝒟1", "𝒟2"}]]data = RandomVariate[QuantityDistribution[ParetoDistribution[2, 3], "Mega" * "USDollars"], 100]FindDistributionParameters[data, QuantityDistribution[ParetoDistribution[minSalary, α], "USDollars"]]オプション (4)
ParameterEstimator (3)
data = RandomVariate[ParetoDistribution[2, 8, 5], 1000];FindDistributionParameters[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfCumulants"]他のモーメントに基づくメソッドも一般に同じような結果を与える:
FindDistributionParameters[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfCentralMoments"]FindDistributionParameters[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfFactorialMoments"]data = RandomVariate[NormalDistribution[2, 3], 1000];FindDistributionParameters[data, NormalDistribution[μ, σ], ParameterEstimator -> "MethodOfMoments"]FindDistributionParameters[data, NormalDistribution[μ, σ], ParameterEstimator -> {"MethodOfMoments", "MomentOrders" -> {1, 4}}]data = RandomVariate[BetaDistribution[2, 3], 1000];FindDistributionParameters[data, BetaDistribution[α, β]]FindMaximumを使って推定する:
FindDistributionParameters[data, BetaDistribution[α, β], ParameterEstimator -> {"MaximumLikelihood", Method -> "FindMaximum"}]EvaluationMonitorを使ってサンプル点を抽出する:
{params, {points}} = Reap[FindDistributionParameters[data, BetaDistribution[α, β], ParameterEstimator -> {"MaximumLikelihood", Method -> {"FindMaximum", EvaluationMonitor :> Sow[{α, β}]}}]];

ListLogPlot[Transpose[points], PlotLegends -> {"α", "β"}]WorkingPrecision (1)
data = RandomVariate[GumbelDistribution[2, 5], 100, WorkingPrecision -> 50];FindDistributionParameters[data, GumbelDistribution[α, β]]FindDistributionParameters[data, GumbelDistribution[α, β], WorkingPrecision -> 25]アプリケーション (17)
母数が1つの推定器を使って別の推定器の初期値を求める (1)
data = {11.3, 19.2, 8.7, 17.5, 7., 17.1, 8.5, 9.8, 15.2, 10.4, 17.9, 20.3, 6.5, 7.9, 11.8, 8.5, 12.8, 14.2, 6.6, 9.};mm = FindDistributionParameters[data, ChiSquareDistribution[n], ParameterEstimator -> "MethodOfMoments"]FindDistributionParameters[data, ChiSquareDistribution[n], mm /. Rule -> List]mle = FindDistributionParameters[data, GammaDistribution[α, β]]FindDistributionParameters[data, GammaDistribution[α, β], mle /. Rule -> List, ParameterEstimator -> "MethodOfMoments"]他の推定のための初期値を得る (1)
ExponentialPowerDistributionからデータのラプラス母数を推定する:
data = RandomVariate[ExponentialPowerDistribution[1.4, 2, 1 / 3], 1000];lparams = FindDistributionParameters[data, LaplaceDistribution[μ, σ]]exppow = FindDistributionParameters[data, ExponentialPowerDistribution[k, μ, σ], Join[{{k, 1}}, lparams /. Rule -> List]]Show[Histogram[data, Automatic, "PDF"], Plot[{PDF[LaplaceDistribution[μ, σ] /. lparams, x], PDF[ExponentialPowerDistribution[k, μ, σ] /. exppow, x]}, {x, 0, 5}, PlotRange -> All, PlotLegends -> {LaplaceDistribution, ExponentialPowerDistribution}]]形状が類似した分布の母数推定 (1)
lnorm = LogNormalDistribution[2, 0.3];sample = RandomVariate[lnorm, 10 ^ 4];edist = FindDistributionParameters[sample, GammaDistribution[α, β]]Plot[{PDF[lnorm, x], PDF[GammaDistribution[α, β] /. edist, x]}, {x, 0, 25}, PlotLegends -> {LogNormalDistribution, GammaDistribution}]事故による保険金請求 (1)
AccidentsPerPolicy = {ConstantArray[0, {81714}], ConstantArray[1, {11306}], ConstantArray[2, {1618}], ConstantArray[3, {250}], ConstantArray[4, {40}], ConstantArray[5, {7}]}//Flatten;保険金請求についての1シフトした対数級数分布の母数  を推定する:
edist = FindDistributionParameters[AccidentsPerPolicy + 1, LogSeriesDistribution[θ]]Show[Plot[LogLikelihood[LogSeriesDistribution[θ], AccidentsPerPolicy + 1], {θ, 0.2, .3}], Graphics[{PointSize[Medium], Red, Point[{θ, LogLikelihood[LogSeriesDistribution[θ], AccidentsPerPolicy + 1]} /. edist]}]]さまざまな言語における単語長 (1)
languages = {"Dutch", "English", "French", "German", "Hebrew", "Polish", "Russian", "Spanish", "Swedish"};worddata = Table[StringLength /@ DictionaryLookup[{l, All}], {l, languages}];
binom = Table[FindDistributionParameters[i, BinomialDistribution[40, p]], {i, worddata}]Partition[Table[Show[Histogram[worddata[[i]], {Range[25] - 1 / 2}, "ProbabilityDensity", PlotLabel -> languages[[i]]], DiscretePlot[PDF[BinomialDistribution[40, p /. binom[[i]]], x], {x, 0, 25}, PlotRange -> All, PlotStyle -> PointSize[.02]]], {i, Length[languages]}], 3]//Gridこの9つの結果に基づいて p 値の分布をブートストラップする:
bootstrap = Mean[RandomChoice[p /. binom, {9, 10000}]];Histogram[bootstrap, Automatic, "ProbabilityDensity"]FindDistributionParameters[bootstrap, NormalDistribution[p, Subscript[σ, p]]]テキスト頻度 (1)
text = ExampleData[{"Text", "OriginOfSpecies"}, "Words"];wordCount = Tally[text][[All, 2]];ZipfDistributionを単語の頻度データにフィットする:
rhohat = FindDistributionParameters[wordCount, ZipfDistribution[ρ]]rhohat を初期値として使い,切断ZipfDistributionを最大50カウントでフィットする:
rhohat50 = FindDistributionParameters[Select[wordCount, # ≤ 50&], ZipfDistribution[50, ρ], rhohat /. Rule -> List]Plot[{CDF[d1 = ZipfDistribution[ρ] /. rhohat, x], CDF[d2 = ZipfDistribution[50, ρ] /. rhohat50, x]}, {x, 0, 50}, PlotLegends -> {d1, d2}]Probability[x > 50, xZipfDistribution[ρ]]% /. rhohat地震のマグニチュード (1)
多峰MixtureDistributionモデルの推定値を求める:
ExampleData[{"Statistics", "USEarthquakes"}, "ColumnDescriptions"]magnitudes = Select[ExampleData[{"Statistics", "USEarthquakes"}], #[[1]] ≥ 1935&][[All, 7]];選択された年代における米国の地震のマグニチュードには2つのモードがある:
h = Histogram[magnitudes, 20, "ProbabilityDensity"]あるNormalDistributionと別の正規分布との可能な混合から分布をフィットする:
dist = MixtureDistribution[{p, 1 - p}, {NormalDistribution[a, b], NormalDistribution[c, d]}];params = FindDistributionParameters[magnitudes, dist]//Quietmeans = {a, c} /. params成分の平均は非常に離れているので,それぞれがモードであると十分に考えられる:
Plot[PDF[dist /. params, x], {x, 2, 8}, PlotRange -> All, Epilog -> {Red, PointSize[Medium], Point[Table[{i, PDF[dist /. params, i]}, {i, means}]]}]風速分析 (1)
maxWinds = WeatherData["Boston", "MaxWindSpeed", {{1950, 1, 1}, {2009, 12, 31}, "Month"}, "Value"]//QuantityMagnitude;データをRayleighDistributionにフィットする:
rparam = FindDistributionParameters[maxWinds, RayleighDistribution[θ]]ExtremeValueDistributionにフィットする:
evparams = FindDistributionParameters[maxWinds, ExtremeValueDistribution[a, b]]経験的変位値とフィットされた変位値を比較してどこでモデルがデータから逸脱しているかを見る:
Row[Table[QuantilePlot[maxWinds, i, PlotLabel -> Head[i]], {i, {RayleighDistribution[θ] /. rparam, ExtremeValueDistribution[a, b] /. evparams}}]]所得分布 (1)
ExampleData[{"Statistics", "UniversitySalaries"}, "ColumnDescriptions"]universityA = Cases[ExampleData[{"Statistics", "UniversitySalaries"}], {dept_, perc_, salary_, campus : "A"} :> {perc, salary}];salaries = Cases[universityA, {p_ ? Positive, s_ ? Positive} :> s / p];dparams = FindDistributionParameters[salaries, DagumDistribution[p, a, b]]pparams = FindDistributionParameters[salaries, ParetoDistribution[k, α, γ, μ], ParameterEstimator -> {"MaximumLikelihood", "Method" -> "SimulatedAnnealing"}]Show[Histogram[salaries, {0, 200000, 10000}, "PDF"], Plot[{PDF[DagumDistribution[p, a, b] /. dparams, x], PDF[ParetoDistribution[k, α, γ, μ] /. pparams, x]}, {x, 0, 200000}, PlotLegends -> {DagumDistribution, ParetoDistribution}]]株式価値の市場変動 (1)
ベータ分布を使ってダウ平均の株式のうちその日に値上がりしたものの割合をモデル化する:
dji = EntityList[EntityClass["Financial", "DowJonesIndustrialAverageComponents"]]Clear[djichange];djichange = DeleteMissing @Table[FinancialData[tick, "FractionalChange", {{2009, 3, 1}, {2013, 3, 1}, "Day"}, "Value"], {tick, dji}];days = First[djichange]["PathLength"]djichangevals = Normal /@ Values /@ djichange;ArrayQ[djichangevals]MatrixPlot[djichangevals, AspectRatio -> 1, FrameLabel -> {"Company", "Day"}]ratios = Table[Count[djichangevals[[All, i]], _ ? Positive] / Length[dji], {i, days}];株価が上昇した企業がない日とすべての企業の株価が上昇した日を除き,母数推定を求める:
posratios = Select[ratios, 0 < # < 1&];
bparams = FindDistributionParameters[posratios, BetaDistribution[α, β]]ContourPlot[LogLikelihood[BetaDistribution[α, β], posratios], {α, 1, 1.5}, {β, 1, 1.4}, Epilog -> {Red, PointSize[Large], Point[{α, β} /. bparams]}]自動車の燃費 (1)
中型車の市街地と高速道路における平均走行可能距離は二変量正規分布に従う:
midsizeMPG2009 = {{16, 22}, {18, 26}, {17, 25}, {16, 23}, {16, 23}, {14, 19}, {13, 19}, {10, 14}, {10, 17}, {18, 28}, {18, 27}, {17, 25}, {17, 25}, {17, 26}, {17, 26}, {16, 25}, {17, 25}, {15, 22}, {15, 23}, {11, 17}, {11, 17}, {17, 28}, {16, 24}, {16, 25}, {16, 25}, {17, 26}, {18, 26}, {17, 26}, {17, 25}, {17, 26}, {13, 19}, {15, 24}, {17, 26}, {15, 22}, {22, 33}, {22, 30}, {18, 29}, {17, 26}, {26, 34}, {21, 30}, {13, 20}, {19, 27}, {16, 27}, {21, 30}, {13, 20}, {19, 27}, {16, 27}, {24, 30}, {23, 27}, {23, 29}, {21, 25}, {19, 27}, {10, 15}, {9, 16}, {17, 25}, {20, 29}, {20, 28}, {18, 26}, {24, 33}, {25, 33}, {16, 25}, {15, 23}, {22, 32}, {22, 32}, {20, 28}, {23, 30}, {24, 32}, {19, 27}, {19, 26}, {18, 25}, {17, 24}, {16, 24}, {16, 23}, {16, 24}, {16, 23}, {20, 22}, {17, 25}, {20, 29}, {20, 28}, {18, 26}, {17, 24}, {18, 28}, {20, 29}, {21, 30}, {17, 25}, {18, 25}, {23, 32}, {17, 24}, {16, 22}, {15, 22}, {13, 19}, {13, 20}, {20, 27}, {16, 25}, {23, 32}, {23, 31}, {18, 27}, {19, 26}, {35, 33}, {19, 26}, {24, 30}, {21, 29}, {26, 31}, {27, 33}, {24, 32}, {11, 18}, {24, 30}, {24, 32}, {22, 33}, {17, 26}, {26, 34}, {21, 31}, {21, 31}, {19, 28}, {33, 34}, {48, 45}, {19, 29}, {15, 23}, {15, 22}, {16, 25}};市街地と高速道路の1ガロンあたりの走行マイル数は正規分布に従い,相関関係があると仮定する:
bparams = FindDistributionParameters[midsizeMPG2009, BinormalDistribution[{μ1, μ2}, {σ1, σ2}, ρ]]市街地と高速道路における推定される平均走行可能距離を抽出する:
{μ1, μ2} /. bparamsρ /. bparams対数スケールで結合密度を可視化し,平均走行可能距離に青い印を付ける:
Show[ContourPlot[Log[PDF[BinormalDistribution[{μ1, μ2}, {σ1, σ2}, ρ] /. bparams, {x, y}]], {x, 0, 50}, {y, 0, 50}, Contours -> 50], Graphics[{PointSize[Medium], Red, Point[{μ1, μ2} /. bparams]}]]地震と地震の間隔 (1)
次のデータは1902年12月16日から1977年3月4日までに世界中で発生した大きい(マグニチュードが7.5以上のあるいは死者が1000人を超える)地震から次の大きい地震までの日数を含んでいる:
earthquakesWaitingTimes = ExampleData[{"Statistics", "EarthquakeWaitingTimes"}];ExponentialDistributionで地震の間隔をモデル化する:
param = FindDistributionParameters[earthquakesWaitingTimes, ExponentialDistribution[λ]]{Mean[ExponentialDistribution[λ]], Median[ExponentialDistribution[λ]]} /. param地震頻度 (1)
1年間の地震の回数はSinghMaddalaDistributionでモデル化することができる:
ExampleData[{"Statistics", "USEarthquakes"}, "Description"]earthquakes = Tally[Select[ExampleData[{"Statistics", "USEarthquakes"}], #[[1]] ≥ 1935&][[All, 1]]][[All, 2]]params = FindDistributionParameters[earthquakes, SinghMaddalaDistribution[q, a, b]]ll = LogLikelihood[SinghMaddalaDistribution[q, a, b], earthquakes] /. paramsTable[With[{var = params[[i, 1]], est = params[[i, 2]]}, Plot[LogLikelihood[SinghMaddalaDistribution[q, a, b] /. Drop[params, {i}], earthquakes], {var, .8est, 1.2est}, Epilog -> {PointSize[Medium], Point[{est, ll}]}, PlotRange -> {Floor[ll], Ceiling[ll]}, PlotLabel -> params[[i]]]], {i, 3}]//Row間欠泉噴出までの時間 (1)
ExampleData[{"Statistics", "OldFaithful"}, "ColumnDescriptions"]waiting = ExampleData[{"Statistics", "OldFaithful"}][[All, 2]];オールド・フェイスフル・ガイザーの噴出から次の噴出までの時間のヒストグラムには2つのモードがある:
h = Histogram[waiting, 25, "ProbabilityDensity"]mdist = MixtureDistribution[{p, 1 - p}, {GammaDistribution[α, β], NormalDistribution[μ, σ]}];mparams = FindDistributionParameters[waiting, mdist, {{p, 1 / 3}, {α, 90}, {β, .5}, {μ, 80}, {σ, 5}}]Show[h, Plot[PDF[mdist /. mparams, x], {x, 0, 100}, PlotStyle -> Thick]]株価分布 (1)
googleStock = QuantityMagnitude@FinancialData["GOOGL", {{2006, 3, 10}, {2018, 3, 15}, "Day"}, "Value"];params = FindDistributionParameters[googleStock, LogNormalDistribution[μ, σ]]1つの母数をフィットされた値に固定して統計データの尤度を可視化する:
Block[{ml = LogLikelihood[LogNormalDistribution[μ, σ] /. params, googleStock], llh1 = LogLikelihood[LogNormalDistribution[mu, σ /. params], googleStock],
	llh2 = LogLikelihood[LogNormalDistribution[μ /. params, s], googleStock]
	}, GraphicsRow[{Plot[llh1, {mu, 5.5, 6.5}, Epilog -> {PointSize[Large], Point[{μ /. params, ml}]}, AxesLabel -> {μ, None}, PlotLabel -> First[params]], Plot[llh2, {s, .1, 1}, Epilog -> {PointSize[Large], Point[{σ /. params, ml}]}, AxesLabel -> {σ, None}, PlotLabel -> Last[params]]}]]
出水率 (1)
マハナディ川の1日あたりの最低出水量を1年ごとに計算したもの(立方メートル/秒)を考える:
minFlow = ExampleData[{"Statistics", "MahanadiRiverFlow"}];1日あたりの最低出水量を1年ごとに計算したものをMinStableDistributionでモデル化する:
params = FindDistributionParameters[minFlow, MinStableDistribution[a, b, c]]次の30年間について,1日あたりの最低出水量を1年ごとに計算したもののシミュレーションを行う:
ListPlot[RandomVariate[MinStableDistribution[a, b, c] /. params, 30], Filling -> 0, AxesOrigin -> {0, 0}]人口規模 (1)
パレート(Pareto)分布を使ってオーストラリアの都市の人口をモデル化する:
cities = CityData[{All, "Australia"}];populations = QuantityMagnitude[CityData[#, "Population"]& /@ cities];params = FindDistributionParameters[populations, ParetoDistribution[k, α, γ, μ]]パレート分布を使ってある都市の人口が少なくとも1万人である確率を推定する:
Probability[x ≥ 10000, xParetoDistribution[k, α, γ, μ]]% /. paramsProbability[x ≥ 10000, xpopulations]//N特性と関係 (8)
FindDistributionParametersは推定を置換規則として与える:
FindDistributionParameters[{5, 8, 3, 4, 9, 6}, PoissonDistribution[μ]]EstimatedDistributionは母数推定を挿入した分布を与える:
EstimatedDistribution[{5, 8, 3, 4, 9, 6}, PoissonDistribution[μ]]FindProcessParametersはランダム過程についての母数推定のリストを返す:
data = RandomFunction[BernoulliProcess[0.4], {0, 10 ^ 5}];FindProcessParameters[data, BernoulliProcess[p]]FindDistributionParametersは分布についての母数推定のリストを返す:
data = RandomVariate[BernoulliDistribution[0.4], 10 ^ 5];FindDistributionParameters[data, BernoulliDistribution[p]]data = RandomVariate[ExponentialDistribution[3], 1000];FindDistributionParameters[data, ExponentialDistribution[λ]]DistributionFitTestを使ってフィットの質を検証する:
ℋ = DistributionFitTest[data, ExponentialDistribution[λ], "HypothesisTestData"]ℋ["FittedDistributionParameters"]ℋ[{"TestDataTable", All}]data = RandomVariate[NormalDistribution[0, 1], 50];pars = FindDistributionParameters[data, NormalDistribution[μ, σ]]SmoothKernelDistributionでノンパラメトリックカーネル密度推定を得る:
skdist = SmoothKernelDistribution[data]ノンパラメトリック分布とパラメトリック分布の確率密度関数を比較する:
Plot[{PDF[skdist, x], PDF[NormalDistribution[μ, σ] /. pars, x]}, {x, -3, 3}, PlotLegends -> {SmoothKernelDistribution, NormalDistribution}]SmoothHistogramを使ってノンパラメトリック密度を可視化する:
SmoothHistogram[data, PlotStyle -> Thick]data = RandomVariate[GammaDistribution[4, 10], 25];edist = FindDistributionParameters[data, GammaDistribution[α, β]]Likelihoodを使って尤度を計算する:
Likelihood[GammaDistribution[α, β] /. edist, data]LogLikelihoodを使って対数尤度を計算する:
LogLikelihood[GammaDistribution[α, β] /. edist, data]data = RandomVariate[BetaDistribution[2, 5], 100];edist = FindDistributionParameters[data, BetaDistribution[α, β], ParameterEstimator -> "MethodOfMoments"]Momentを使ってデータから原点の周りのモーメントを計算する:
{Moment[data, 1], Moment[data, 2]}{Moment[BetaDistribution[α, β], 1], Moment[BetaDistribution[α, β], 2]} /. edistdata = RandomVariate[WeibullDistribution[3, 15], 100];edist = FindDistributionParameters[data, WeibullDistribution[α, β]]QuantilePlotを使って経験的変位値と理論的変位値を可視化する:
QuantilePlot[data, WeibullDistribution[α, β] /. edist]推定がQuantilePlot内で行われる場合に同じ可視化を行う:
QuantilePlot[data, WeibullDistribution[α, β]]FindDistributionParametersは,TimeSeriesとEventSeriesのタイムスタンプを無視する:
ts = TemporalData[TimeSeries, {{{1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 0, 0, 1,
    0, 1, 0, 1, 0, 0, 0, 1, 0, 1, 0, 1, 0, 0, 1, 0, 0, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 0,
    0, 0, 0, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 0, 1, 1, 0, 0, 0, 0, 0, 0, 1, 0, 1, 0, 1, 1, 1, 0, 0,
    1, 0, 0, 0, 1, 1, 1, 0, 1, 1, 1, 1}}, {{0, 99, 1}}, 1, {"Continuous", 1}, {"Discrete", 1}, 1,
{ResamplingMethod -> {"Interpolation", InterpolationOrder -> 1}}}, False, 10.1];FindDistributionParameters[ts, BernoulliDistribution[p]]FindDistributionParameters[ts["Values"], BernoulliDistribution[p]]TemporalDataについては,すべての経路構造が無視される:
td = TemporalData[«4»];FindDistributionParameters[td, NormalDistribution[a, b]]FindDistributionParameters[td["ValueList"]//Flatten, NormalDistribution[a, b]]考えられる問題 (3)
モーメント法方程式の解は有効ではない母数を与えることがある:
FindDistributionParameters[{10, 12, 8, 15}, BinomialDistribution[n, p], ParameterEstimator -> "MethodOfMoments"]DistributionParameterAssumptions[BinomialDistribution[n, p]] /. %data = RandomVariate[NormalDistribution[-1, .1], 10 ^ 3];FindDistributionParameters[data, NormalDistribution[m, m], ParameterEstimator -> "MethodOfMoments"]DistributionParameterQ[NormalDistribution[m, m] /. %]
よい解を得るためには初期値をうまく選ぶ必要があるかもしれない:
data = {4.1, 5.8, 4.3, 5.6, 3.8, 2.5, 3.1, 5.3, 5.4, 3.3};FindDistributionParameters[data, RiceDistribution[.01, α, β], ParameterEstimator -> "MethodOfMoments"]
FindDistributionParameters[data, RiceDistribution[.01, α, β], {{α, 4}, {β, .02}}, ParameterEstimator -> "MethodOfMoments"]data = RandomVariate[DirichletDistribution[Range[25]], 10 ^ 4];FindDistributionParameters[data, DirichletDistribution[Array[g, 25]]]//AbsoluteTimingFindDistributionParameters[data, DirichletDistribution[Array[g, 25]], Transpose[{Array[g, 25], Range[25]}]]//AbsoluteTimingテキスト
Wolfram Research (2010), FindDistributionParameters, Wolfram言語関数, https://reference.wolfram.com/language/ref/FindDistributionParameters.html.
CMS
Wolfram Language. 2010. "FindDistributionParameters." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/FindDistributionParameters.html.
APA
Wolfram Language. (2010). FindDistributionParameters. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/FindDistributionParameters.html