

LocationEquivalenceTest
LocationEquivalenceTest[{data1,data2,…}]
dataiの平均あるいは中央値が等しいかどうかの検定を行う.
LocationEquivalenceTest[{data1,…},"property"]
"property"の値を返す.
詳細とオプション
- LocationEquivalenceTestは,母集団の真の位置母数が等しい
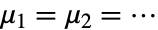 という帰無仮説
 と少なくとも1つが異なるという対立仮説
 を使い,dataiについて仮説検定を行う.
- デフォルトで,確率の値すなわち
 値が返される.
- 小さい
 値は
 が真である可能性が低いことを示す.
- dataiは一変量{x1,x2,…}でなければならない.
- LocationEquivalenceTest[{data1,…}]はデータに適用できる最も強力な検定を選ぶ.
- LocationEquivalenceTest[{data1,…},All]はデータに適用できるすべての検定を選ぶ.
- LocationEquivalenceTest[{data1,…},"test"]は"test"による
 値をレポートする.
- 平均値に基づく検定は dataiが正規分布に従うと仮定する.中央値に基づくクラスカル・ウォリス(Kruskal–Wallis)検定は dataiが共通の中央値について対称であると仮定する.完全ブロック
 検定とフリードマン(Friedman)順位検定はデータが完全乱塊にあると仮定する.いずれの検定でも dataiの分散が同じであることが求められる.
- 使用可能な検定
-
"CompleteBlockF" 正規性,ブロック法 完全ブロック法のための平均検定 "FriedmanRank" ブロック法 完全ブロック法のための中央値検定 "KruskalWallis" 対称性 2つ以上のサンプルについての中央値検定 "KSampleT" 正規性 2つ以上のサンプルについての平均検定 - 完全ブロック
 検定は,事実上,完全乱塊法の一元配置分散分析を行う.
- フリードマン順位検定はデータの行ごとに観測値を順位付けし,各列で順位の合計を求めることで検定統計量を求める.検定統計量は,同順位については修正される.
- クラスカル・ウォリス検定は,事実上データの順位について一元配置分散分析を行う.検定統計量は,同順位については修正される.
 サンプルの
 検定は,データの一元配置分散分析に等しい.
- LocationEquivalenceTest[{data1,…},"HypothesisTestData"]は,htd["property"]という形で追加的な検定結果と特性を抽出するのに使えるHypothesisTestDataオブジェクト htd を返す.
- LocationEquivalenceTest[{data1,…},"property"]を使って"property"の値を直接与えることができる.
- 検定結果のレポートに関連する特性
-
"AllTests" 適用可能なすべての検定のリスト "AutomaticTest" Automaticが使われた場合に選ばれる検定 "DegreesOfFreedom" 検定で使われる自由度 "PValue"  値のリスト
"PValueTable"  値のフォーマットされた表
"ShortTestConclusion" 検定結果の簡単な説明 "TestConclusion" 検定結果の説明 "TestData" 検定統計量と  値のペアのリスト
"TestDataTable"  値と検定統計量のフォーマットされた表
"TestStatistic" 検定統計量のリスト "TestStatisticTable" 検定統計量のフォーマットされた表 - 使用可能なオプション
-
Method Automatic  値の計算に使うメソッド
SignificanceLevel 0.05 診断とレポートのための切捨て VerifyTestAssumptions Automatic 証明すべき仮定 - 位置検定では,
 のときにのみ
 が棄却されるような切捨て
 が選ばれる."TestConclusion"および"ShortTestConclusion"特性に使われる
 の値はSignificanceLevelオプションで制御される.値
 は正規性,等分散性,対称性の検定等を含む仮定の診断検定にも使われる.デフォルトで,
 は0.05に設定されている.
- LocationEquivalenceTestのVerifyTestAssumptionsの名前付き設定値
-
"Normality" すべてのデータが正規分布に従うことを証明 "EqualVariance" dataiの分散が等しいことを証明 "Symmetry" 共通の平均値について対称であることを証明
例題
すべて開く すべて閉じる例 (3)
2つ以上の母集団の平均あるいは中央値がすべて等しいかどうかの検定を行う:
data1 = RandomVariate[NormalDistribution[.25, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 1], 150];
data3 = RandomVariate[NormalDistribution[0, 1], 135];LocationEquivalenceTest[{data1, data2, data3}, {"TestDataTable", All}]特性を繰り返し抽出するためにHypothesisTestDataオブジェクトを作る:
ℋ = LocationEquivalenceTest[{data1, data2, data3}, "HypothesisTestData"]ℋ["Properties"]完全ブロック  検定を使って完全ブロック法の平均差の検定を行うことができる:
data = {{36.05, 52.47, 56.55, 45.2, 35.25, 66.38, 40.57, 57.15, 28.34}, {42.47, 85.15, 63.20, 52.10, 66.20, 73.25, 44.50, 57.17, 35.05}, {51.50, 65, 73.1, 64.4, 57.45, 76.49, 40.55, 66.47, 33.17}, {37.55, 59.3, 79.12, 58.33, 70.54, 69.47, 46.48, 66.35, 36.2}};SmoothHistogram[data, 20]Mean /@ dataLocationEquivalenceTest[data, {"TestDataTable", "CompleteBlockF"}]フリードマン順位検定を使って完全ブロック法で中央値の差を検定する:
data = {{70, 77, 76, 80, 84, 78}, {61, 75, 67, 63, 66, 68}, {82, 88, 90, 96, 92, 98}, {74, 76, 80, 76, 84, 86}};SmoothHistogram[data, 10]Mean /@ data//NLocationEquivalenceTest[data, {"TestDataTable", "FriedmanRank"}]スコープ (9)
検定 (5)
data = RandomVariate[NormalDistribution[], {2, 10^3}];LocationEquivalenceTest[data, "KSampleT"]LocationEquivalenceTest[data, {"KSampleT", "KruskalWallis"}]data = RandomVariate[NormalDistribution[], {5, 250}];LocationEquivalenceTest[data, All]特性"AllTests"を使ってどの検定が使われたかを調べる:
LocationEquivalenceTest[data, "AllTests"]繰り返して特性を抽出するためにHypothesisTestDataオブジェクトを作る:
data = RandomVariate[NormalDistribution[], {3, 10^4}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];ℋ["Properties"]HypothesisTestDataオブジェクトからいくつかの特性を抽出する:
data = RandomVariate[NormalDistribution[], {3, 10^2}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];


ℋ["PValue", "KSampleT"]ℋ["TestStatistic", "KSampleT"]data = RandomVariate[NormalDistribution[], {3, 10^3}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];
ℋ[{{"PValue", "KruskalWallis"}, {"TestStatistic", "KruskalWallis"}}]レポート (4)
data = RandomVariate[NormalDistribution[], {4, 20}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];ℋ["TestDataTable", "KSampleT"]ℋ["TestDataTable", All]ℋ["TestDataTable", {"KSampleT", "KruskalWallis"}]data = BlockRandom[SeedRandom[2];RandomVariate[NormalDistribution[], {2, 10^3}]];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];res = ℋ["TestData", All];tests = ℋ["AllTests"] 値は0.05よりも大きいので,このレベルでは
 を棄却するだけの十分な証拠はない:
Show[BarChart[res[[All, 2]], ChartLabels -> Placed[tests, Center], BarOrigin -> Left], Graphics[{Dashed, InfiniteLine[{{.05, 0}, {.05, 1}}]}]]
data = RandomVariate[NormalDistribution[], {2, 10^2}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];ℋ["PValueTable", "KSampleT"]
ℋ["PValue", "KSampleT"]
ℋ["PValueTable", All]
ℋ["PValueTable", {"KSampleT", "KruskalWallis"}]data = RandomVariate[CauchyDistribution[1, 2], {2, 10^3}];ℋ = LocationEquivalenceTest[data, "HypothesisTestData"];ℋ[Automatic]ℋ["TestStatistic"]ℋ["TestStatisticTable", All]オプション (8)
Method (2)
data = RandomVariate[NormalDistribution[], {5, 100}];{χ, p} = LocationEquivalenceTest[data, {"TestData", "KruskalWallis"}]再スケールされた検定統計量はFRatioDistributionに従う:
fFromChi[χ_, n_, g_] := ((n - g)χ/(g - 1)(n - 1 - χ))SurvivalFunction[FRatioDistribution[4, 495], fFromChi[χ, 500, 5]]{χ, p} = LocationEquivalenceTest[data, {"TestData", "KruskalWallis"}, Method -> "Asymptotic"]SurvivalFunction[ChiSquareDistribution[4], χ]data = RandomVariate[NormalDistribution[], {5, 100}];LocationEquivalenceTest[data, {"TestDataTable", "FriedmanRank"}, Method -> "Asymptotic"]
LocationEquivalenceTest[data, {"TestDataTable", "FriedmanRank"}]SignificanceLevel (3)
data = BlockRandom[SeedRandom[2];RandomVariate[StudentTDistribution[3], {3, 50}]];LocationEquivalenceTest[data, "KSampleT", SignificanceLevel -> .005]LocationEquivalenceTest[data, "KSampleT", SignificanceLevel -> Automatic]
data = BlockRandom[SeedRandom[1];RandomVariate[StudentTDistribution[3], {3, 50}]];LocationEquivalenceTest[data, "AutomaticTest", SignificanceLevel -> .005]LocationEquivalenceTest[data, "AutomaticTest", SignificanceLevel -> Automatic]有意水準は"TestConclusion"と"ShortTestConclusion"にも使われる:
BlockRandom[SeedRandom[1];data1 = RandomVariate[NormalDistribution[.1, 1], 500];
	data2 = RandomVariate[NormalDistribution[.1, 1], 500];
data3 = RandomVariate[NormalDistribution[0, 1], 500]];LocationEquivalenceTest[{data1, data2, data3}, "TestConclusion", SignificanceLevel -> .005]//TraditionalFormLocationEquivalenceTest[{data1, data2, data3}, "TestConclusion", SignificanceLevel -> .05]//TraditionalFormLocationEquivalenceTest[{data1, data2, data3}, "ShortTestConclusion", SignificanceLevel -> .005]LocationEquivalenceTest[{data1, data2, data3}, "ShortTestConclusion", SignificanceLevel -> .05]VerifyTestAssumptions (3)
診断は,AllあるいはNoneを使ってまとめて制御することができる:
data = RandomVariate[StudentTDistribution[3], {4, 1000}];LocationEquivalenceTest[data, "KSampleT", VerifyTestAssumptions -> All]
LocationEquivalenceTest[data, "KSampleT", VerifyTestAssumptions -> None]data = RandomVariate[StudentTDistribution[3], {4, 1000}];LocationEquivalenceTest[data, "KSampleT", VerifyTestAssumptions -> "Symmetry"]LocationEquivalenceTest[data, "KSampleT", VerifyTestAssumptions -> "Normality"]
data = RandomVariate[CauchyDistribution[0, 1], {3, 100}];LocationEquivalenceTest[data, "TestDataTable"]LocationEquivalenceTest[data, "TestDataTable", VerifyTestAssumptions -> "Normality" -> True]データが正規分布に従っていなかったため,上記ではクラスカル・ウォリス検定が選ばれた:
LocationEquivalenceTest[data, {"TestDataTable", "KSampleT"}]
アプリケーション (4)
data1 = Table[RandomVariate[NormalDistribution[μ, 1], 100], {μ, RandomReal[{-3, 3}, 8]}];data2 = Table[RandomVariate[NormalDistribution[μ, 1], 100], {μ, RandomReal[{-.05, .05}, 8]}];{BoxWhiskerChart[data1], BoxWhiskerChart[data2]}最初のデータ集合群は,全く異なる位置を持つ母集団から引き出された:
LocationEquivalenceTest[data1, "TestDataTable"]LocationEquivalenceTest[data2, "TestDataTable"]2種類のカニの形態学的な寸法が2つの性のそれぞれについて取られた.さまざまな群において寸法が異なるかどうかを判断する:
ExampleData[{"Statistics", "CrabMeasures"}, "ColumnDescriptions"]{variety, gender, FL, RW, CL, CW} = Transpose[ExampleData[{"Statistics", "CrabMeasures"}][[All, {1, 2, 4, 5, 6, 7}]]];MapThread[SmoothHistogram[Table[Pick[#1, gender, sp], {sp, DeleteDuplicates[gender]}], PlotLabel -> #2, Ticks -> None]&, {{FL, RW, CL, CW}, {"Frontal Lobe", "Rear Width", "Carapace Length", "Carapace Width"}}]LocationEquivalenceTest[Table[Pick[#, gender, sp], {sp, DeleteDuplicates[gender]}], "TestDataTable"]& /@ {FL, RW, CL, CW}MapThread[SmoothHistogram[Table[Pick[#1, Transpose[{variety, gender}], sp], {sp, DeleteDuplicates[Transpose[{variety, gender}]]}], PlotLabel -> #2, Ticks -> None]&, {{FL, RW, CL, CW}, {"Frontal Lobe", "Rear Width", "Carapace Length", "Carapace Width"}}]性と種類を同時に考慮に入れると,すべての寸法は有意的に異なる:
LocationEquivalenceTest[Table[Pick[#, Transpose[{variety, gender}], sp], {sp, DeleteDuplicates[Transpose[{variety, gender}]]}], "TestDataTable"]& /@ {FL, RW, CL, CW}特定の薬で目標の体重減量を達成できなかった2型糖尿病の患者75人に対して,試験的研究が行われた.患者は,ランダムに3つの群(もとの薬を飲み続けた対照群,およびそれぞれ50mgと100mgの新しい薬を投与された2つの治療群)に分けられた.12週間における減量をポンドで記録した:
control = {-1.2, 0.8, -0.4, 1.5, 1.7, 0.1, 0.9, 0.5, 1.9, 2.3, -0.2, 0.1, 1.7, 1.5, 0.5, 1.9, 2.1, 0.1, 2.4, 0.9, 0., 1.7, 1.9, 0.2, 2.2};treat50 = {3.4, 4.9, 3.2, 6.2, 2.7, 2.7, 3.7, 6.1, 4.6, 5.7, 4.1, 5.3, 5.9, 5.0, 7.1, 5.0, 4.7, 5.6, 6.3, 2.0, 5.8, 8.2, 6.5, 7.1, 4.7};treat100 = {1.5, 2.0, 1.0, 3.7, 5.7, 3.7, 6.1, 4.5, 7.1, 2.9, 3.1, 4.6, 6.4, 5.1, 5.5, 6.1, 5.1, 6.1, 1.4, 1.5, 5.4, 3.8, 3.1, 3.2, 2.7};SmoothHistogram[{control, treat50, treat100}, Frame -> True, Axes -> None, PlotLegends -> {"control", "treat50", "treat100"}]LocationEquivalenceTest[{control, treat50, treat100}, "TestDataTable"]それぞれ対の差分の検定においてBonferroni修正を使うと,どちらの治療レベル群も対照群よりよい結果であるが,お互いにはあまり違いのないことが分かる:
α = 0.05;LocationEquivalenceTest[{control, treat50}, "ShortTestConclusion", SignificanceLevel -> α / 3]LocationEquivalenceTest[{control, treat100}, "ShortTestConclusion", SignificanceLevel -> α / 3]//QuietLocationEquivalenceTest[{treat50, treat100}, "ShortTestConclusion", SignificanceLevel -> α / 3]6人の料理評論家が4軒のレストランの品質について100点満点で評価を行った.この評価に照らして,4件のレストランの品質に有意差が見られるかどうかを考える:
data = {{70, 77, 76, 80, 84, 78}, {61, 75, 67, 63, 66, 68}, {82, 88, 90, 96, 92, 98}, {74, 76, 80, 76, 84, 86}};BarChart[Median[data], ChartLabels -> {"C1", "C2", "C3", "C4", "C5", "C6"}]BarChart[Median /@ data, ChartLabels -> {"A", "B", "C", "D"}]ブロック化された構造を考慮に入れると,品質に有意差が認められる:
LocationEquivalenceTest[data, {"TestDataTable", {"FriedmanRank", "CompleteBlockF"}}]特性と関係 (12)
 サンプルの
 検定で返された
 値は,2サンプルのTTestのそれに等しい:
data = RandomVariate[NormalDistribution[], {2, 100}];LocationEquivalenceTest[data, {"PValueTable", "KSampleT"}]TTest[data, 0, "PValueTable", VerifyTestAssumptions -> None]クラスカル・ウォリス検定は2サンプルのマン-ホイットニー(Mann–Whitney)検定の  サンプル拡張である:
data = RandomVariate[NormalDistribution[], {2, 1000}];LocationEquivalenceTest[data, {"PValueTable", "KruskalWallis"}]マン-ホイットニーの  値は,連続性とタイについて修正される:
MannWhitneyTest[data, 0, "PValueTable"] において
 サンプルの
 検定の統計量は,g がデータ集合数,n が観察の合計数であるFRatioDistribution[g-1,n-g]に従う:
data = RandomVariate[NormalDistribution[], {1000, 3, 200}];kst = LocationEquivalenceTest[#, {"TestStatistic", "KSampleT"}, VerifyTestAssumptions -> None]& /@ data;df = LocationEquivalenceTest[data[[1]], "DegreesOfFreedom"]Show[Plot[PDF[FRatioDistribution[df[[1]], df[[2]]], x], {x, 0, 5}, PlotRange -> {0, 1}], SmoothHistogram[kst, PlotStyle -> Orange]]DistributionFitTest[kst, FRatioDistribution[df[[1]], df[[2]]]] の下では,t 処理と g ブロックの完全ブロック
 検定とフリードマンの順位検定統計量はFRatioDistribution[t-1,(g-1)(t-1)]に従う:
data = RandomVariate[NormalDistribution[], {1000, 3, 200}];cbf = LocationEquivalenceTest[#, {"TestStatistic", "CompleteBlockF"}, VerifyTestAssumptions -> None]& /@ data;frt = LocationEquivalenceTest[#, {"TestStatistic", "FriedmanRank"}, VerifyTestAssumptions -> None]& /@ data;df = LocationEquivalenceTest[data[[1]], {"DegreesOfFreedom", "CompleteBlockF"}]Table[Show[Plot[PDF[FRatioDistribution[df[[1]], df[[2]]], x], {x, 0, 5}, PlotRange -> {0, 1}], SmoothHistogram[i, PlotStyle -> Orange]], {i, {cbf, frt}}]Table[DistributionFitTest[i, FRatioDistribution[df[[1]], df[[2]]]], {i, {cbf, frt}}]フリードマン統計を変換してChiSquareDistribution[g-1]に従うようにすることができる:
data = RandomVariate[NormalDistribution[], {1000, 3, 200}];frt = LocationEquivalenceTest[#, {"TestStatistic", "FriedmanRank"}, VerifyTestAssumptions -> None]& /@ data;df = LocationEquivalenceTest[data[[1]], {"DegreesOfFreedom", "FriedmanRank"}]chiFromF[F_, df1_, df2_] := (df1 (df1 + df2) F/df2 + df1 F)chisqrs = (chiFromF[#1, df[[1]], df[[2]]]&) /@ frt;Show[Plot[PDF[ChiSquareDistribution[df[[1]]], x], {x, 0, 10}, PlotRange -> {0, .5}], SmoothHistogram[chisqrs, PlotStyle -> Orange]]ChiSquareDistributionを使って  値を計算する:
f = LocationEquivalenceTest[data[[1]], {"TestStatistic", "FriedmanRank"}]Probability[χ > chiFromF[f, df[[1]], df[[2]]], χChiSquareDistribution[df[[1]]]]Methodを"Asymptotic"に設定すると自動的にこの変換が行われる:
LocationEquivalenceTest[data[[1]], "FriedmanRank", Method -> "Asymptotic"] においてクラスカル・ウォリス検定の統計量は,g がデータ集合数である ChiSquareDistribution[g-1]に漸近的に従う:
data = RandomVariate[NormalDistribution[], {1000, 3, 200}];kst = LocationEquivalenceTest[#, {"TestStatistic", "KruskalWallis"}, VerifyTestAssumptions -> None]& /@ data;Show[Plot[PDF[ChiSquareDistribution[2], x], {x, 0, 20}, PlotRange -> All], SmoothHistogram[kst, PlotStyle -> Orange]]DistributionFitTest[kst, ChiSquareDistribution[2]]デフォルトで検定統計量はFRatioDistribution[g-1,n-g]に従うように再スケールされる:
fFromChi[χ_, n_, g_] := ((n - g)χ/(g - 1)(n - 1 - χ))DistributionFitTest[fFromChi[#, 600, 3]& /@ kst, FRatioDistribution[2, 597]]μDifferent = {-3, 0, 3};
μSimilar = {0, 0, 0};σ = 1;dDifferent = Table[RandomVariate[NormalDistribution[i, σ], 10 ^ 4], {i, μDifferent}];
dSimilar = Table[RandomVariate[NormalDistribution[i, σ], 10 ^ 4], {i, μSimilar}];{SmoothHistogram[Flatten[dDifferent]], SmoothHistogram[Flatten[dSimilar]]}Variance[Flatten[dDifferent]] / Mean[Variance /@ dDifferent]Variance[Flatten[dSimilar]] / Mean[Variance /@ dSimilar]LocationEquivalenceTestは事実上この割合がどのくらい1から離れているかを検出する:
LocationEquivalenceTest[dDifferent]LocationEquivalenceTest[dSimilar] および
 の検定統計量がLocationEquivalenceTestで使われる:
data = RandomVariate[NormalDistribution[], {3, 15}];ChiSquareStat[data_] := Block[{n = Length /@ data, g = Length[data], m = Mean /@ data, mbar = Mean[Flatten@data]},
(Total[n] - 1)((Underoverscript[∑, i = 1, g]n[[i]] (m[[i]] - mbar)^2/Underoverscript[∑, i = 1, g]Underoverscript[∑, j = 1, n[[i]]](data[[i, j]] - mbar)^2))//N
]fFromChi[χ_, n_, g_] := ((n - g)χ/(g - 1)(n - 1 - χ))fFromChi[ChiSquareStat[data], 3 * 15, 3]LocationEquivalenceTest[data, {"TestStatistic", "KSampleT"}]ranks = Partition[Ordering[Ordering[Flatten@data]], 15];ChiSquareStat[ranks]LocationEquivalenceTest[data, {"TestStatistic", "KruskalWallis"}] 個のサンプルの
 検定とクラスカル・ウォリス検定では,LinearModelFitを使って統計量を計算することができる:
n = 15;g = 3;data = RandomVariate[NormalDistribution[], {g, n}];designMat[n_, g_] := Block[{tot = Total[n]}, f[i_] := With[{nstart = If[i == 1, 1, Total[n[[1 ;; i - 1]]] + 1]}, ReplacePart[ConstantArray[0, tot], x_ /; nstart ≤ x < Total[n[[1 ;; i]]] + 1 -> 1]];Transpose[Join[{ConstantArray[1, tot]}, Table[f[i], {i, Range[g - 1]}]]]]

loctst[dat_] := Block[{lm, MSR, MSE},
	lm = LinearModelFit[{designMat[ConstantArray[n, g], g], dat}];
	MSR = (Total[lm["ANOVATableSumsOfSquares"][[1 ;; g - 1]]]/g - 1);
	MSE = (lm["ANOVATableSumsOfSquares"][[-2]]/Length[dat] - g);
	MSR / MSE
]loctst[Flatten@data]LocationEquivalenceTest[data, {"TestStatistic", "KSampleT"}]loctst[Ordering[Ordering[Flatten@data]]]fFromChi[χ_, n_, g_] := ((n - g)χ/(g - 1)(n - 1 - χ))fFromChi[LocationEquivalenceTest[data, {"TestStatistic", "KruskalWallis"}], n * g, g]2つのデータ集合についてLocationTestを使う:
BlockRandom[SeedRandom[10];data = RandomVariate[NormalDistribution[0, 1], {2, 100}]];LocationEquivalenceTest[data, "KSampleT"]LocationTest[data, Automatic, "T"]LocationTestはより複雑な仮説についての検定を行うこともできる:
LocationTest[data, 1.5, {"TestDataTable", "T"}, AlternativeHypothesis -> "Less"]位置の等価性検定は,入力がTimeSeriesのときはタイムスタンプを無視する:
ts1 = TemporalData[TimeSeries, {{{1.224578634529677, 0.47929635789978015, 0.6572781300178168,
    0.21496048742669355, 0.7299608014554928, -0.2495111111278263, -1.3286551762002712,
    0.552725018274874, 0.19272112205837066, 1.1809144012420882, -1.1671 ... 40938613662046, 1.052394590214582, 0.9345044123980388, 0.38537803109557855,
    -0.48660931166089394, -0.71203560340161}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];ts2 = TemporalData[TimeSeries, {{{-1.2160757838495546, 0.5212591188357838, -0.0932747538180776,
-2.306367634798702, -2.5366722726947994, -0.7924813212437647, -2.65435901675047,
-1.1098678592653723, -0.7814091835518528, -1.9685555851254093, -0.0 ... 1001061264, -0.1887471329804458, -2.0547107874294928, -1.3896240275653011,
-0.5073077090484948, 0.13302942350391606}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];LocationEquivalenceTest[{ts1, ts2}]LocationEquivalenceTest[{ts1["Values"], ts2["Values"]}]位置の等価性に関する検定は,TemporalDataの経路構造を認識する:
td = TemporalData[Automatic, {{{0.6327956976018951, 0.49307164456668334, -0.11865815946302549,
    -1.6346246228913748, -1.8053674367955113, -1.0171193599509663, -1.713536030590108,
    -0.2441834126183119, 1.468610531363788, 2.5403283801476966, 0.862 ... 135928877112, 0.8411464201445826, 0.36308201253335104, -0.45737292436875443,
    0.289078430933834, 0.12996366812717347}}, {{0, 100, 1}}, 4, {"Continuous", 4}, {"Discrete", 1},
1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];LocationEquivalenceTest[td]LocationEquivalenceTest[td["ValueList"]]考えられる問題 (3)
data1 = RandomVariate[NormalDistribution[0, 100], 100];
data2 = RandomVariate[NormalDistribution[], 100];
data3 = RandomVariate[NormalDistribution[1, 1], 100];LocationEquivalenceTest[{data1, data2, data3}, All]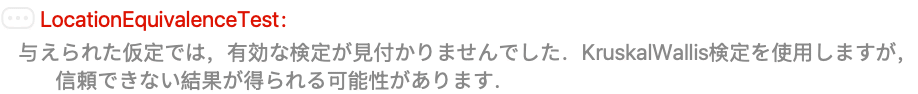
 個のサンプルの
 検定と完全ブロック
 検定は,どちらもデータが正規分布に従わなければならない:
data1 = RandomVariate[LaplaceDistribution[0, 1 / Sqrt[2]], 100];
data2 = RandomVariate[NormalDistribution[], 100];
data3 = RandomVariate[NormalDistribution[1, 1], 100];LocationEquivalenceTest[{data1, data2, data3}, {"CompleteBlockF", "KSampleT"}]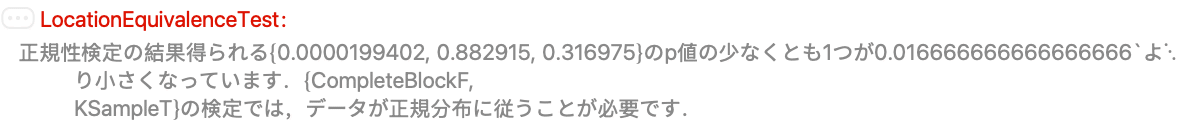
データが正規分布に従わない場合は,クラスカル・ウォリス検定またはフリードマン順位検定を使う必要がある:
LocationEquivalenceTest[{data1, data2, data3}, "KruskalWallis"]フリードマン順位検定と完全ブロック  検定ではサンプルサイズが等しくなければならない:
data1 = RandomVariate[NormalDistribution[], 100];
data2 = RandomVariate[NormalDistribution[], 100];
data3 = RandomVariate[NormalDistribution[], 15];LocationEquivalenceTest[{data1, data2, data3}, {"CompleteBlockF", "FriedmanRank"}]
おもしろい例題 (1)

data1 = RandomVariate[NormalDistribution[], {250, 100}];
data2 = RandomVariate[NormalDistribution[0, 2], {250, 100}];T1 = MapThread[LocationEquivalenceTest[{#1, #2}, "TestStatistic"]&, {data1, data2}];data3 = RandomVariate[NormalDistribution[1, 1], {250, 100}];T2 = MapThread[LocationEquivalenceTest[{#1, #2}, "TestStatistic"]&, {data1, data3}];SmoothHistogram[{T1, T2}, Filling -> Axis, PlotLegends -> {"SubscriptBox[H, 0]は真", "SubscriptBox[H, 0]は偽"}]テキスト
Wolfram Research (2010), LocationEquivalenceTest, Wolfram言語関数, https://reference.wolfram.com/language/ref/LocationEquivalenceTest.html.
CMS
Wolfram Language. 2010. "LocationEquivalenceTest." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/LocationEquivalenceTest.html.
APA
Wolfram Language. (2010). LocationEquivalenceTest. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/LocationEquivalenceTest.html