

SignedRankTest
SignedRankTest[data]
data の中央値が0かどうかの検定を行う.
SignedRankTest[{data1,data2}]
data1-data2の中央値が0かどうかの検定を行う.
SignedRankTest[dspec,μ0]
μ0について位置測定の検定を行う.
SignedRankTest[dspec,μ0,"property"]
"property"の値を返す.
詳細とオプション
- SignedRankTestは,帰無仮説
 と対立仮説
 で検定を行う.
-


data 

{data1,data2} 

- ただし,μ は data の母集団中央値,μ12は2つのデータ集合のペアになった差分
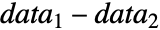 の中央値である.
- デフォルトで,確率値つまり
 値が返される.
- 小さい
 値は
 が真である可能性が低いことを示唆している.
- dspec 中のデータは一変量{x1,x2,…}でも多変量{{x1,y1,…},{x2,y2,…},…}でもよい.
- 2つのサンプルを与える場合,両者は同じ長さでなければならない.
- 引数 μ0は実数あるいはデータの次元と同じ長さの実ベクトルでよい.
- SignedRankTestは一変量の場合はデータが中央値について対称であり,多変量の場合はデータが中央値について楕円対称であると仮定する.ゆえに,SignedRankTestは平均検定でもある.
- SignedRankTest[dspec,μ0,"HypothesisTestData"]はHypothesisTestDataオブジェクト htd を返す.これは htd["property"]として追加的な検定結果と特性の抽出に使うことができる.
- SignedRankTest[dspec,μ0,"property"]を使って直接"property"の値を与えることができる.
- 検定結果のレポートに関連する特性
-
"DegreesOfFreedom" 検定で使用される自由度 "PValue"  値のリスト
"PValueTable"  値のフォーマットされた表
"ShortTestConclusion" 検定結果の簡単な説明 "TestConclusion" 検定結果の説明 "TestData" 検定統計と  値のペアのリスト
"TestDataTable" 検定統計と  値のフォーマットされた表
"TestStatistic" 検定統計のリスト "TestStatisticTable" 検定統計のフォーマットされた表 - SignedRankTestはSignTestより強力な選択肢である.
- 一変量のサンプルについては,ペアになったサンプルの中央値についてSignedRankTestはウィルコクソン(Wilcoxon)の符号順位検定を行う.置換に基づいた
 値にはタイの修正が行われる.デフォルトで,検定統計は連続性について修正され,漸近的な結果が返される.
- 多変量のサンプルについては,SignedRankTestは標準化された空間的符号順位を用いて,ペアのサンプルについてアフィン不変量検定を行う.検定統計はChiSquareDistribution[dim]に従うと仮定される.ただし,dim はデータの次元である.
- 使用可能なオプション
-
AlternativeHypothesis "Unequal" 対立仮説のための不等式 MaxIterations Automatic 多変量中央値検定のための最大反復回数 Method Automatic  値を計算するメソッド
SignificanceLevel 0.05 診断とレポートのための切捨て VerifyTestAssumptions Automatic どの仮定を検証するか - SignedRankTestでは,
 のときにのみ
 が棄却されるような切捨て
 が選択される.特性"TestConclusion"および"ShortTestConclusion"で使われる
 の値はSignificanceLevelオプションで制御される.
 の値は対称性の検定を含む仮定の診断検定にも使われる.デフォルトで,
 は0.05に設定されている.
- SignedRankTestにおけるVerifyTestAssumptionsの名前付き設定
-
"Symmetry" すべてのデータが対称であることを証明する
例題
すべて開く すべて閉じる例 (4)
data = RandomVariate[NormalDistribution[], 100];DistributionChart[data]SignedRankTest[data]data = RandomVariate[MultinormalDistribution[{2, 0}, {{1, .75}, {.75, 1}}], 1000];BoxWhiskerChart[Transpose@data]SignedRankTest[Transpose@data, 2]SignedRankTest[Transpose@data, 2, "TestDataTable"]多変量母集団の空間的中央値がなんらかの値かどうかの検定を行う:
data = RandomVariate[MultinormalDistribution[{4, 5, 6}, IdentityMatrix[3]], 10^2];SignedRankTest[data, {4, 5, 6}]SignedRankTest[data, {4, 5, 6}, "TestStatistic"]繰り返し特性を抽出するためにHypothesisTestDataオブジェクトを作る:
data = RandomVariate[StudentTDistribution[4], 100];ℋ = SignedRankTest[data, Automatic, "HypothesisTestData"]ℋ["Properties"]ℋ["TestData"]ℋ["TestDataTable", "PValue", "TestStatistic"]スコープ (13)
検定 (10)


data1 = RandomVariate[NormalDistribution[0, 1], 500];
data2 = RandomVariate[NormalDistribution[3, 1], 500];
SignedRankTest[data1]
SignedRankTest[data2]Automaticを使うことは,ゼロの中央値について検定することと同じである:
data = RandomVariate[NormalDistribution[0, 1], 500];SignedRankTest[data, 0]SignedRankTest[data, Automatic]


data1 = RandomVariate[NormalDistribution[3, 1], 500];
data2 = RandomVariate[NormalDistribution[0, 1], 500];
SignedRankTest[data1, 3]
SignedRankTest[data2, 3]多変量母集団の中央値ベクトルがゼロベクトルであるかどうかを検定する:
data = RandomVariate[MultinormalDistribution[{.1, 0, -.5, 0}, IdentityMatrix[4]], 10^2];SignedRankTest[data]SignedRankTest[data, {0.1, 0, -.5, 0}]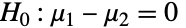
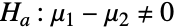
data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[1, 1], 100];
data3 = RandomVariate[NormalDistribution[0, 2], 100];
SignedRankTest[{data1, data2}, 0]
SignedRankTest[{data1, data3}, 0]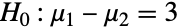
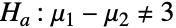
data1 = RandomVariate[NormalDistribution[3, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 1], 100];SignedRankTest[{data1, data2}, 3]SignedRankTest[{data2, data1}, 3]2つの多変量母集団の中央値の差分ベクトルがゼロベクトルであるかどうかの検定を行う:
data1 = RandomVariate[MultinormalDistribution[{.5, 0, -.5, 0}, IdentityMatrix[4]], 10^2];data2 = RandomVariate[MultinormalDistribution[{-.5, 0, .5, 0}, IdentityMatrix[4]], 10^2];SignedRankTest[{data1, data2}]SignedRankTest[{data1, data2}, {1, 0, -1, 0}]繰り返し特性を抽出するためにHypothesisTestDataオブジェクトを作成する:
data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = SignedRankTest[data, 0, "HypothesisTestData"];ℋ["Properties"]HypothesisTestDataオブジェクトから特性を抽出する:
data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = SignedRankTest[data, 0, "HypothesisTestData"];
ℋ["PValue"]ℋ["TestStatistic"]data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = SignedRankTest[data, 0, "HypothesisTestData"];
ℋ["PValue", "TestStatistic"]レポート (3)
data = RandomVariate[NormalDistribution[], {2, 20}];ℋ = SignedRankTest[data, 0, "HypothesisTestData"];ℋ["TestDataTable"]data = RandomVariate[NormalDistribution[], {1000, 25}];res = Table[SignedRankTest[i, 0, "TestData", VerifyTestAssumptions -> None], {i, data}];ListPlot[res, PlotStyle -> PointSize[Medium]]
data = RandomVariate[NormalDistribution[], {2, 10^2}];ℋ = SignedRankTest[data, 0, "HypothesisTestData"];ℋ["PValueTable"]
ℋ["PValue"]ℋ["TestStatisticTable"]ℋ["TestStatistic"]オプション (12)
AlternativeHypothesis (3)
data = RandomVariate[NormalDistribution[], {2, 100}];
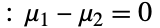

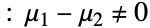
SignedRankTest[data, 0, AlternativeHypothesis -> "Unequal"]SignedRankTest[data, 0, AlternativeHypothesis -> Automatic]data = RandomVariate[NormalDistribution[], {2, 100}];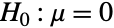
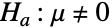
SignedRankTest[data, 0, AlternativeHypothesis -> "Unequal"]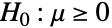
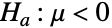
SignedRankTest[data, 0, AlternativeHypothesis -> "Less"]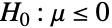
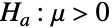
SignedRankTest[data, 0, AlternativeHypothesis -> "Greater"]data1 = RandomVariate[NormalDistribution[2.9, 1], 1000];
data2 = RandomVariate[NormalDistribution[0, 1], 1000];Mean[data1 - data2]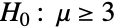
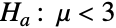
SignedRankTest[{data1, data2}, 3, AlternativeHypothesis -> "Less"]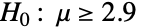
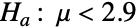
SignedRankTest[{data1, data2}, 2.9, AlternativeHypothesis -> "Less"]MaxIterations (2)
data1 = RandomVariate[BinormalDistribution[.5], 25];
data2 = RandomVariate[BinormalDistribution[.5], 25];SignedRankTest[{data1, data2}, Automatic, MaxIterations -> 500]SignedRankTest[{data1, data2}, Automatic, MaxIterations -> Automatic]最大反復数を設定することによって,結果として共分散の不足をもたらすことがある:
BlockRandom[SeedRandom[2];
	data1 = RandomVariate[BinormalDistribution[.5], 25];
	data2 = RandomVariate[BinormalDistribution[.5], 25];]
SignedRankTest[{data1, data2}, Automatic, MaxIterations -> 1]
SignedRankTest[{data1, data2}, Automatic, MaxIterations -> Automatic]Method (4)
デフォルトでは,漸近的な検定統計分布を使って  値が計算される:
data = RandomVariate[NormalDistribution[], {2, 100}];SignedRankTest[data, 0, Method -> Automatic]SignedRankTest[data, 0, Method -> "Asymptotic"]data = RandomVariate[NormalDistribution[], {2, 35}];SignedRankTest[data, 0, Method -> "Asymptotic"]SignedRankTest[data, 0, Method -> "Permutation"]data = RandomVariate[NormalDistribution[], {2, 35}];SignedRankTest[data, 0, Method -> {"Permutation", "MonteCarloSamples" -> 10^3}]SignedRankTest[data, 0, Method -> {"Permutation", "MonteCarloSamples" -> 10^5}]
SignedRankTest[data, 0, Method -> {"Permutation", "MonteCarloSamples" -> 10^4}]data = RandomVariate[NormalDistribution[], {2, 35}];SignedRankTest[data, 0, Method -> {"Permutation", "RandomSeed" -> 0}]SignedRankTest[data, 0, Method -> {"Permutation", "RandomSeed" -> 9}]SignificanceLevel (1)
有意水準は"TestConclusion"と"ShortTestConclusion"に使われる:
BlockRandom[SeedRandom[1];data = RandomVariate[NormalDistribution[0, 1], {2, 100}]];ℋ1 = SignedRankTest[data, .2, "HypothesisTestData", SignificanceLevel -> .05];ℋ2 = SignedRankTest[data, .2, "HypothesisTestData", SignificanceLevel -> .001];ℋ1["TestConclusion"]//TraditionalFormℋ2["TestConclusion"]//TraditionalFormℋ1["ShortTestConclusion"]ℋ2["ShortTestConclusion"]VerifyTestAssumptions (2)
診断は,AllかNoneを使ってまとめて制御することができる:
data1 = RandomVariate[ExponentialDistribution[1], 100];
data2 = RandomVariate[ExponentialDistribution[1], 100];SignedRankTest[{data1, data2}, 0, VerifyTestAssumptions -> All]
SignedRankTest[{data1, data2}, 0, VerifyTestAssumptions -> None]data1 = RandomVariate[ExponentialDistribution[1], 1000];
data2 = RandomVariate[ExponentialDistribution[1], 1000];SignedRankTest[{data1, data2}, 0, VerifyTestAssumptions -> "Symmetry"]
対称性の仮定をTrueに設定する:
SignedRankTest[{data1, data2}, 0, VerifyTestAssumptions -> "Symmetry" -> True]アプリケーション (1)
12組の一卵性双生児に対して積極性を測る心理検査が行われた.最初に生まれた双子の方が後に生まれた双子よりも積極的であることが多いという仮説が立てられた:
first = {86, 71, 77, 68, 91, 72, 77, 91, 70, 71, 88, 87};
second = {88, 77, 76, 64, 96, 72, 65, 90, 65, 80, 81, 72};BarChart[first - second]生まれた順序は積極性に影響を与えないという  を退けるのに十分な証拠がない:
SignedRankTest[{first, second}, 0, "TestDataTable", AlternativeHypothesis -> "Greater"]特性と関係 (8)
SignedRankTestは一般にSignTestよりも強力である:
data = RandomVariate[NormalDistribution[1, 1], {250, 15}];Subscript[p, SR] = Table[SignedRankTest[i, VerifyTestAssumptions -> None], {i, data}];
Subscript[p, SGN] = Table[SignTest[i], {i, data}];Probability[x ≤ .05, xSubscript[p, SR]]//NProbability[x ≤ .05, xSubscript[p, SGN]]//N一変量のウィルコクソン(Wilcoxon)の符号順位検定統計:
data = RandomVariate[NormalDistribution[], 100];Subscript[μ, 0] = 0;タイがないので,Orderingを使って順位を計算することができる:
WSR[data_, μ0_] := With[{dat = data - μ0}, Total[Pick[Sign[dat] * Ordering[Ordering[Abs@dat]], Sign[dat], 1]]]WSR[data, Subscript[μ, 0]]SignedRankTest[data, Subscript[μ, 0], "TestDataTable"]
WSRP[data_] := With[{ranks = Sign[data] Ordering[Ordering[Abs[data]]], d = NormalDistribution[]}, 2. Min[CDF[d, (Total[ranks] + 1/Sqrt[ranks.ranks])], SurvivalFunction[d, (Total[ranks] - 1/Sqrt[ranks.ranks])]]]WSRP[data - Subscript[μ, 0]]data = RandomVariate[NormalDistribution[], {1000, 100}];T = Table[Quiet@SignedRankTest[i, Automatic, "TestStatistic"], {i, data}];DistributionFitTest[T, NormalDistribution[μ, σ]]多変量データについては,検定統計は  においてChiSquareDistributionに従う:
data = RandomVariate[BinormalDistribution[.5], {250, 15}];T = Table[SignedRankTest[i, Automatic, "TestStatistic"], {i, data}];df = Dimensions[data[[1]]][[2]]DistributionFitTest[T, ChiSquareDistribution[df]]多変量データについては,SignedRankTestは事実上単位球の一様性について検定を行う:
μ = {{0, 0}, {.5, .5}, {1, 1}, {10, 10}};data = Table[RandomVariate[ProductDistribution[NormalDistribution[i[[1]], 1], NormalDistribution[i[[2]], 1]], 100], {i, μ}];SSR[data_] := Block[{n, p, item, dmt, dpt, dm, dp, out = {}}, {n, p} = Dimensions[data];Do[dmt = dpt = Table[0., {p}];Do[dm = i - j;dp = i + j;dmt = dmt + (If[#1 == 0, dm, (dm/#1)]&)[Sqrt[dm.dm]];dpt = dpt + (If[#1 == 0, dp, (dp/#1)]&)[Sqrt[dp.dp]];, {j, data}];item = (dmt + dpt/2 n);out = Join[{item}, out], {i, data}];out]μ0からの偏差は,空間符号順位のクラスタとより大きい検定統計を返す:
Table[Show[ListPlot[SSR[i], AspectRatio -> 1, PlotStyle -> PointSize[Medium], PlotLabel -> Row[{"SR: ", SignedRankTest[i, Automatic, "TestStatistic"]}], PlotRange -> {{-1, 1}, {-1, 1}}], Graphics[Circle[]]], {i, data}]data = RandomVariate[MultinormalDistribution[{0, 0}, IdentityMatrix[2]], 100];𝒯 = AffineTransform[{{{1, 2}, {3, 4}}, {1, 2}}];SignedRankTest[data, {0, 0}, "TestDataTable"]SignedRankTest[𝒯[data], 𝒯[{0, 0}], "TestDataTable"]符号順位検定は,入力がTimeSeriesのときにのみ値に使うことができる:
ts = TemporalData[TimeSeries, {{{1.224578634529677, 0.47929635789978015, 0.6572781300178168,
    0.21496048742669355, 0.7299608014554928, -0.2495111111278263, -1.3286551762002712,
    0.552725018274874, 0.19272112205837066, 1.1809144012420882, -1.1671 ... 40938613662046, 1.052394590214582, 0.9345044123980388, 0.38537803109557855,
    -0.48660931166089394, -0.71203560340161}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];SignedRankTest[ts]SignedRankTest[ts["Values"]]符号順位検定は,入力がTemporalDataのときには,すべての値に同時に使うことができる:
td = TemporalData[Automatic, {{{-0.25275046867718637, -0.7175779198306353, -1.9370139837317764,
    0.006665621735740701, -0.3730807122324292, 0.6740106823161018, 0.8562214990564344,
    0.955785083955732, 1.7020898014886303, 1.8523009430646802, 0.244 ... 3951759101545, -1.1611722313627828, 1.1602446901533021,
    1.1052173095128992, 1.1089143920161917, -0.13837156328402}}, {{0, 100, 1}}, 2,
  {"Continuous", 2}, {"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False,
10.1];SignedRankTest[td]data = td["ValueList"]//Flatten;
SignedRankTest[data]{data1, data2} = td["ValueList"];SignedRankTest[{data1, data2}]考えられる問題 (1)
SignedRankTestでは,データは共通の中央値について対称でなければならない:
BlockRandom[SeedRandom[3];data1 = RandomVariate[NormalDistribution[], 100];
data2 = RandomVariate[ExponentialDistribution[2], 100]];SignedRankTest[{data1, data2}, VerifyTestAssumptions -> "Symmetry"]
データが対称ではない場合はSignTestを使う:
SignTest[{data1, data2}]おもしろい例題 (1)

data1 = RandomVariate[NormalDistribution[], {2500, 100}];
data2 = RandomVariate[NormalDistribution[], {2500, 100}];T1 = MapThread[SignedRankTest[{#1, #2}, 0, "TestStatistic"]&, {data1, data2}];T2 = MapThread[SignedRankTest[{#1, #2}, 1, "TestStatistic"]&, {data1, data2}];SmoothHistogram[{T1, T2}, Filling -> Axis, PlotLegends -> {"SubscriptBox[H, 0]は真", "SubscriptBox[H, 0]は偽"}]テキスト
Wolfram Research (2010), SignedRankTest, Wolfram言語関数, https://reference.wolfram.com/language/ref/SignedRankTest.html.
CMS
Wolfram Language. 2010. "SignedRankTest." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/SignedRankTest.html.
APA
Wolfram Language. (2010). SignedRankTest. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/SignedRankTest.html