



EstimatedDistribution
EstimatedDistribution[data,dist]
data からのパラメトリック分布 dist を推定する.
EstimatedDistribution[data,dist,{{p,p0},{q,q0},…}]
初期値を p0, q0, …として,母数 p, q, …を推定する.
EstimatedDistribution[data,dist,idist]
初期値を例示された分布 idist から取った分布 dist を推定する.
詳細とオプション
- EstimatedDistributionは,母数推定を任意の非数値のために挿入した分布 dist を返す.
- data は与えられた分布 dist からの可能な結果のリストでなければならない.
- 分布 dist は,母数が不明な任意の一変量あるいは多変量のパラメトリック分布,あるいは派生分布でよい.
- 使用可能なオプション
-
AccuracyGoal Automatic 目標確度 ParameterEstimator "MaximumLikelihood" 使用する母数推定器 PrecisionGoal Automatic 目標精度 WorkingPrecision Automatic 内部計算精度 - ParameterEstimatorには次の基本設定が使える.
-
"MaximumLikelihood" 対数尤度関数を最大化する "MethodOfMoments" 原点の周りのモーメントをマッチする "MethodOfCentralMoments" 中心モーメントをマッチする "MethodOfCumulants" キュムラントをマッチする "MethodOfFactorialMoments" 階乗モーメントをマッチする - 最尤法は対数尤度関数
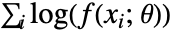 を最大化しようとする.ただし,
 は分布母数であり
 は分布の確率密度関数である.
- モーメント法は
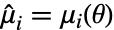 ,
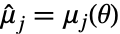 ,
 を解くことができる.ただし,
 は

 次サンプルモーメント,
 は分布の

 次モーメントで,母数は
 である.
- モーメント法に基づく推定器は母数についてのすべての制約を満たさないことがある.
例題
すべて開く すべて閉じる例 (3)
data = RandomVariate[𝒟 = GammaDistribution[1, 2], 10 ^ 3];e𝒟 = EstimatedDistribution[data, GammaDistribution[α, β]]もとの分布と推定された分布の確率密度関数を可視化して比較する:
Plot[{PDF[𝒟, x], PDF[e𝒟, x]}, {x, 0, 10}, PlotLegends -> {"𝒟", "e𝒟"}]EstimatedDistribution[data, GammaDistribution[α, β], ParameterEstimator -> "MethodOfMoments"]data = RandomVariate[MultivariatePoissonDistribution[5, {4, 3, 10}], 20];EstimatedDistribution[data, MultivariatePoissonDistribution[μ, {Subscript[μ, 1], Subscript[μ, 2], Subscript[μ, 3]}]]data = RandomVariate[NormalDistribution[Quantity[200, "Centimeters"], Quantity[7, "Centimeters"]], 20]EstimatedDistribution[data, NormalDistribution[m, s]]スコープ (15)
基本的な用法 (5)
bdata = {23, 16, 24, 17, 16, 17, 18, 17, 19, 23, 19, 13, 19, 18, 22, 21, 19, 22, 19, 23};EstimatedDistribution[bdata, BinomialDistribution[n, p]]EstimatedDistribution[bdata, BinomialDistribution[50, p]]EstimatedDistribution[bdata, BinomialDistribution[n, 2 / 5]]vals = RandomReal[ChiSquareDistribution[20], 1000];dist = EstimatedDistribution[vals, ChiSquareDistribution[n]]データのヒストグラムと推定値の確率密度関数を比較することで適合度を調べる:
Show[Histogram[vals, Automatic, "ProbabilityDensity"], Plot[PDF[dist, x], {x, 0, 50}]]DistributionFitTest[vals, dist, {"TestDataTable", All}]DistributionFitTest[vals, ChiSquareDistribution[n], {"TestDataTable", All}]data = RandomVariate[GeometricDistribution[.4], 100];dist = EstimatedDistribution[data, GeometricDistribution[p]]phat = dist[[1]]対数尤度関数をプロットし,解が最適であることを視覚的に調べる:
Show[Plot[LogLikelihood[GeometricDistribution[p], data], {p, 0, 1}], Graphics[{PointSize[Large], Red, Point[{phat, LogLikelihood[GeometricDistribution[phat], data]}]}]]data = BlockRandom[SeedRandom[100];RandomVariate[WeibullDistribution[4, 5], 50]];ContourPlot[LogLikelihood[WeibullDistribution[α, β], data], {α, 2, 6}, {β, 3, 8}]EstimatedDistribution[data, WeibullDistribution[α, β], WeibullDistribution[3, 5.5]]data = RandomVariate[PoissonDistribution[20], 100];EstimatedDistribution[data, NormalDistribution[μ, σ]]EstimatedDistribution[data, NormalDistribution[μ, σ], WorkingPrecision -> 20]一変量パラメトリック分布 (2)
data = {0.8, 0.98, 0.66, 0.09, 0.03, 0.16, 0.88, 0.32, 0.56, 0.3, 0.82, 0.34, 0.93, 0.33, 0.25, 0.74, 0.3, 0.74, 0.16, 0.02};EstimatedDistribution[data, BetaDistribution[α, β]]QuantilePlot[data, %]data = {16, 1, 2, 5, 3, 5, 1, 6, 4, 14, 2, 9, 1, 1, 2, 2, 8, 1, 3, 1};EstimatedDistribution[data, LogSeriesDistribution[θ]]多変量パラメトリック分布 (2)
mdata = RandomVariate[MultinomialDistribution[20, {1 / 3, 1 / 6, 1 / 10, 2 / 5}], 1000];EstimatedDistribution[mdata, MultinomialDistribution[n, {Subscript[p, 1], Subscript[p, 2], Subscript[p, 3], Subscript[p, 4]}]]bndata = RandomVariate[BinormalDistribution[{1, 2}, {1 / 3, 4}, 3 / 4], 1000];dist = EstimatedDistribution[bndata, BinormalDistribution[{Subscript[μ, 1], Subscript[μ, 2]}, {Subscript[σ, 1], Subscript[σ, 2]}, ρ]]Plot3D[PDF[BinormalDistribution[{1, 2}, {1 / 3, 4}, 3 / 4], {x, y}] - PDF[dist, {x, y}], {x, 0, 2}, {y, -10, 16}, PlotRange -> All]派生分布 (6)
𝒟o = TruncatedDistribution[{-1, 2}, NormalDistribution[1, 1 / 3]];SeedRandom[1];
data = RandomVariate[𝒟o, 100];𝒟e = EstimatedDistribution[data, TruncatedDistribution[{-1, 2}, NormalDistribution[μ, σ]]]Plot[{PDF[𝒟o, x], PDF[𝒟e, x]}, {x, -1, 3}, Filling -> Axis, PlotLegends -> {"𝒟o", "𝒟e"}]dist = ProbabilityDistribution[λ Exp[λ(1 - x)], {x, 1, Infinity}, Assumptions -> λ > 0]EstimatedDistribution[{1.4, 5.1, 1.7, 1.6, 1.1, 3.9, 2.2, 1.3, 2., 1.5}, dist]data = RandomVariate[ProductDistribution[BetaDistribution[2, 3], LaplaceDistribution[10, 1]], 100];EstimatedDistribution[data, ProductDistribution[BetaDistribution[α, β], LaplaceDistribution[μ, σ]]]𝒟o = CopulaDistribution[{"Frank", 1 / 2}, {GammaDistribution[2, 3], ChiSquareDistribution[10]}];data = RandomVariate[𝒟o, 100];𝒟e = EstimatedDistribution[data, CopulaDistribution[{"Frank", c}, {GammaDistribution[α, β], ChiSquareDistribution[n]}]]Plot3D[CDF[𝒟o, {x, y}] - CDF[𝒟e, {x, y}], {x, 0, 25}, {y, 0, 35}, PlotRange -> All]data = RandomVariate[MixtureDistribution[{1 / 3, 2 / 3}, {GammaDistribution[2, 3], NormalDistribution[1, 1 / 4]}], 100];EstimatedDistribution[data, MixtureDistribution[{p, 1 - p}, {GammaDistribution[α, β], NormalDistribution[μ, σ]}]]//QuietEstimatedDistribution[data, MixtureDistribution[{p, 1 - p}, {GammaDistribution[2, 3], NormalDistribution[1, 1 / 4]}]]//Quietdata = RandomVariate[NormalDistribution[Quantity[200, "Centimeters"], Quantity[7, "Centimeters"]], 100]EstimatedDistribution[data, QuantityDistribution[NormalDistribution[m, s], "Meters"]]オプション (4)
ParameterEstimator (3)
data = RandomVariate[ParetoDistribution[2, 8, 5], 1000];EstimatedDistribution[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfCentralMoments"]他のモーメントに基づいたメソッドも一般にこれに似た結果を与える:
EstimatedDistribution[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfCentralMoments"]EstimatedDistribution[data, ParetoDistribution[α, β, μ], ParameterEstimator -> "MethodOfFactorialMoments"]data = RandomVariate[NormalDistribution[2, 3], 1000];EstimatedDistribution[data, NormalDistribution[μ, σ], ParameterEstimator -> "MethodOfMoments"]EstimatedDistribution[data, NormalDistribution[μ, σ], ParameterEstimator -> {"MethodOfMoments", "MomentOrders" -> {1, 4}}]data = RandomVariate[BetaDistribution[2, 3], 1000];EstimatedDistribution[data, BetaDistribution[α, β]]FindMaximumを使って推定する:
EstimatedDistribution[data, BetaDistribution[α, β], ParameterEstimator -> {"MaximumLikelihood", Method -> "FindMaximum"}]EvaluationMonitorを使ってサンプル点を抽出する:
{params, {points}} = Reap[EstimatedDistribution[data, BetaDistribution[α, β], ParameterEstimator -> {"MaximumLikelihood", Method -> {"FindMaximum", EvaluationMonitor :> Sow[{α, β}]}}]];

ListLogPlot[Transpose[points], PlotLegends -> {"α", "β"}]WorkingPrecision (1)
data = RandomVariate[GumbelDistribution[2, 5], 100, WorkingPrecision -> 50];EstimatedDistribution[data, GumbelDistribution[α, β]]EstimatedDistribution[data, GumbelDistribution[α, β], WorkingPrecision -> 25]アプリケーション (14)
形状が類似した分布の推定 (1)
lnorm = LogNormalDistribution[2, 0.3];sample = RandomVariate[lnorm, 10 ^ 4];edist = EstimatedDistribution[sample, GammaDistribution[α, β]]Show[Histogram[sample, 20, "ProbabilityDensity"], Plot[PDF[edist, x], {x, 0, 20}, PlotStyle -> Thick]]Plot[{PDF[lnorm, x], PDF[edist, x]}, {x, 0, 25}]事故による保険金請求 (1)
ある保険会社の保険1件あたりの1年間の事故による保険金請求件数:
accidentsPerPolicyCounts = {81714, 11306, 1618, 250, 40, 7};;accidentsPerPolicy = WeightedData[Range[0, 5], accidentsPerPolicyCounts]ほとんどの保険契約について多くても1回しか請求がないので,対数級数分布でデータをモデル化する:
edist = EstimatedDistribution[WeightedData[Range[0, 5] + 1, accidentsPerPolicyCounts], LogSeriesDistribution[θ]]Show[Histogram[accidentsPerPolicy, {-0.5, 5.5, 1}, "PDF"], DiscretePlot[PDF[edist, x + 1], {x, 0, 5}, PlotStyle -> PointSize[Medium]]]さまざまな言語における単語長 (1)
languages = {"Arabic", "English", "Finnish", "French", "Hebrew", "Hindi", "Italian", "Russian", "Spanish"};worddata = Table[StringLength /@ DictionaryLookup[{l, All}], {l, languages}];それぞれの言語について二項分布であると仮定して単語の長さをモデル化する:
binom = Table[EstimatedDistribution[i, BinomialDistribution[n, p], ParameterEstimator -> {"MaximumLikelihood", Method -> {"FindRoot", MaxIterations -> 1000}}], {i, worddata}]Partition[Table[Show[Histogram[worddata[[i]], {Range[25] - 1 / 2}, "ProbabilityDensity", PlotLabel -> languages[[i]]], DiscretePlot[PDF[binom[[i]], x], {x, 0, 25}, PlotRange -> All, PlotStyle -> PointSize[.025]]], {i, Length[languages]}], 3]//Gridテキスト頻度 (1)
text = ExampleData[{"Text", "OriginOfSpecies"}, "Words"];wordCount = Tally[text][[All, 2]];ZipfDistributionを単語頻度のデータにフィットする:
edist = EstimatedDistribution[wordCount, ZipfDistribution[ρ]]Show[Histogram[wordCount, {0.5, 20.5, 1}, "ProbabilityDensity"], DiscretePlot[PDF[edist, x], {x, 0, 20}, PlotStyle -> PointSize[Medium]]]地震のマグニチュード (1)
EstimatedDistributionをMixtureDistributionのような構造と一緒に使って多峰モデルを構築することができる:
magnitudes = Select[ExampleData[{"Statistics", "USEarthquakes"}], #[[1]] ≥ 1935&][[All, 7]];アメリカ合衆国における1935年から1989年までの地震のマグニチュードには2つのはモードがある:
h = Histogram[magnitudes, 20, "ProbabilityDensity"]あるNormalDistributionと別の正規分布の可能な混合から分布をフィットする:
edist = EstimatedDistribution[magnitudes, MixtureDistribution[{p, 1 - p}, {NormalDistribution[a, b], NormalDistribution[c, d]}]]//QuietShow[h, Plot[PDF[edist, x], {x, 0, 10}, PlotStyle -> Thick, PlotRange -> All]]Probability[x ≥ 7, xedist]Mean[edist]ListPlot[RandomVariate[edist, 30], Filling -> Axis]風速分析 (1)
maxWinds = WeatherData["Boston", "MaxWindSpeed", {{1950, 1, 1}, {2009, 12, 31}, "Month"}, "Value"]//QuantityMagnitude;データをRayleighDistributionにフィットする:
edist1 = EstimatedDistribution[maxWinds, RayleighDistribution[θ]]ExtremeValueDistributionにフィットする:
edist2 = EstimatedDistribution[maxWinds, ExtremeValueDistribution[a, b]]経験的な変位値とフィットされた分布のそれを比較して,モデルがデータから逸脱している箇所を確かめる:
Row[Table[QuantilePlot[maxWinds, i, PlotLabel -> Head[i]], {i, {edist1, edist2}}]]所得分布 (1)
ExampleData[{"Statistics", "UniversitySalaries"}, "ColumnDescriptions"]universityA = Cases[ExampleData[{"Statistics", "UniversitySalaries"}], {dept_, perc_, salary_, campus : "A"} :> {perc, salary}];salaries = Cases[universityA, {p_ ? Positive, s_ ? Positive} :> s / p];edist = EstimatedDistribution[salaries, DagumDistribution[p, a, b]]給与がより一般的なパレート(Pareto)分布に従うと仮定する:
edist2 = EstimatedDistribution[salaries, ParetoDistribution[k, α, γ, μ], ParameterEstimator -> {"MaximumLikelihood", "Method" -> "SimulatedAnnealing"}]Show[Histogram[salaries, {0, 200000, 10000}, "PDF"], Plot[{PDF[edist, x], PDF[edist2, x]}, {x, 0, 200000}, PlotStyle -> Thick, PlotLegends -> {DagumDistribution, ParetoDistribution}]]自動車の燃費 (1)
中型車の市街地と高速道路における平均的な走行可能距離は二変量正規分布に従う:
midsizeMPG2009 = {{16, 22}, {18, 26}, {17, 25}, {16, 23}, {16, 23}, {14, 19}, {13, 19}, {10, 14}, {10, 17}, {18, 28}, {18, 27}, {17, 25}, {17, 25}, {17, 26}, {17, 26}, {16, 25}, {17, 25}, {15, 22}, {15, 23}, {11, 17}, {11, 17}, {17, 28}, {16, 24}, {16, 25}, {16, 25}, {17, 26}, {18, 26}, {17, 26}, {17, 25}, {17, 26}, {13, 19}, {15, 24}, {17, 26}, {15, 22}, {22, 33}, {22, 30}, {18, 29}, {17, 26}, {26, 34}, {21, 30}, {13, 20}, {19, 27}, {16, 27}, {21, 30}, {13, 20}, {19, 27}, {16, 27}, {24, 30}, {23, 27}, {23, 29}, {21, 25}, {19, 27}, {10, 15}, {9, 16}, {17, 25}, {20, 29}, {20, 28}, {18, 26}, {24, 33}, {25, 33}, {16, 25}, {15, 23}, {22, 32}, {22, 32}, {20, 28}, {23, 30}, {24, 32}, {19, 27}, {19, 26}, {18, 25}, {17, 24}, {16, 24}, {16, 23}, {16, 24}, {16, 23}, {20, 22}, {17, 25}, {20, 29}, {20, 28}, {18, 26}, {17, 24}, {18, 28}, {20, 29}, {21, 30}, {17, 25}, {18, 25}, {23, 32}, {17, 24}, {16, 22}, {15, 22}, {13, 19}, {13, 20}, {20, 27}, {16, 25}, {23, 32}, {23, 31}, {18, 27}, {19, 26}, {35, 33}, {19, 26}, {24, 30}, {21, 29}, {26, 31}, {27, 33}, {24, 32}, {11, 18}, {24, 30}, {24, 32}, {22, 33}, {17, 26}, {26, 34}, {21, 31}, {21, 31}, {19, 28}, {33, 34}, {48, 45}, {19, 29}, {15, 23}, {15, 22}, {16, 25}};市街地と高速道路の1ガロンあたりの走行マイル数は正規分布に従い,相関関係があると仮定する:
edist = EstimatedDistribution[midsizeMPG2009, BinormalDistribution[{μ1, μ2}, {σ1, σ2}, ρ]]Plot[Evaluate[PDF[MarginalDistribution[edist, #], x]& /@ {1, 2}], {x, 5, 40}, Filling -> Axis, PlotLegends -> {"city", "highway"}]ContourPlot[Log[PDF[edist, {x, y}]], {x, 0, 50}, {y, 0, 50}, Contours -> 50]地震と地震の間隔 (1)
次のデータは1902年12月16日から1977年3月4日までに世界中で発生した大きい(マグニチュードが7.5以上もしくは死者が1000人以上の)地震から次の大きい地震までの日数を含んでいる:
earthquakesWaitingTimes = ExampleData[{"Statistics", "EarthquakeWaitingTimes"}];ExponentialDistributionで地震の間隔をモデル化する:
edist = EstimatedDistribution[earthquakesWaitingTimes, ExponentialDistribution[λ]]{Mean[edist], Median[edist]}地震頻度 (1)
1年間の地震の回数はSinghMaddalaDistributionでモデル化することができる:
ExampleData[{"Statistics", "USEarthquakes"}, "ColumnDescriptions"]earthquakes = Tally[Select[ExampleData[{"Statistics", "USEarthquakes"}], #[[1]] ≥ 1935&][[All, 1]]][[All, 2]]edist = EstimatedDistribution[earthquakes, SinghMaddalaDistribution[q, a, b]]Show[Histogram[earthquakes, 15, "ProbabilityDensity"], Plot[PDF[edist, x], {x, 0, 140}, PlotStyle -> Thick]]アメリカ合衆国で1年間に最低でも60回の地震が発生する確率を求める:
NProbability[x ≥ 60, xedist]間欠泉噴出までの時間 (1)
ExampleData[{"Statistics", "OldFaithful"}, "ColumnDescriptions"]waiting = ExampleData[{"Statistics", "OldFaithful"}][[All, 2]];オールド・フェイスフル・ガイザーの噴出から次の噴出までの時間のヒストグラムには2つのモードがある:
h = Histogram[waiting, 20, "ProbabilityDensity"]MixtureDistributionをデータにフィットする:
mdist = MixtureDistribution[{1 / 3, 2 / 3}, {GammaDistribution[a, b], GammaDistribution[c, d]}];edist = Quiet@EstimatedDistribution[waiting, mdist, {{a, 85}, {b, .5}, {c, 195}, {d, .4}}]Show[h, Plot[PDF[edist, x], {x, 0, 100}, PlotStyle -> Thick]]NProbability[x > 80, xedist]次の60回の噴出について噴出から噴出までの時間のシミュレーションを行う:
times = RandomVariate[edist, 60];ListPlot[{times, {{1, m1}, {60, m1}}, {{1, m2}, {60, m2}}}, Joined -> {False, True, True}, Filling -> {1 -> Axis}, AxesOrigin -> {0, 40}]株価分布 (1)
出水率 (1)
マハナディ川の1日あたりの最低流量を1年ごとに計算したもの(立方メートル/秒)を考える:
minFlow = ExampleData[{"Statistics", "MahanadiRiverFlow"}];1日あたりの最低流量を1年ごとに計算したものをMinStableDistributionでモデル化する:
edist = EstimatedDistribution[minFlow, MinStableDistribution[a, b, c]]Show[Histogram[minFlow, 10, "ProbabilityDensity"], Plot[PDF[edist, x], {x, 0, 7}, PlotStyle -> Thick]]次の30年間について,1日あたりの最低流量を1年ごとに計算したもののシミュレーションを行う:
ListLinePlot[RandomVariate[edist, 30]]人口規模 (1)
パレート分布を使ってオーストラリアの都市の人口をモデル化する:
cities = CityData[{All, "Australia"}];populations = QuantityMagnitude[CityData[#, "Population"]& /@ cities];edist = EstimatedDistribution[populations, ParetoDistribution[k, α, γ, μ]]Probability[x ≥ 10000, xedist]Probability[x ≥ 10000, xpopulations]//N特性と関係 (8)
EstimatedDistributionは母数推定を挿入した分布を与える:
EstimatedDistribution[{5, 8, 3, 4, 9, 6}, PoissonDistribution[μ]]FindDistributionParametersは母数推定を置換規則として与える:
FindDistributionParameters[{5, 8, 3, 4, 9, 6}, PoissonDistribution[μ]]EstimatedProcessはパラメトリック過程を推定する:
data = RandomFunction[BernoulliProcess[0.4], {0, 10 ^ 5}];EstimatedProcess[data, BernoulliProcess[p]]EstimatedDistributionはパラメトリック分布を推定する:
data = RandomVariate[BernoulliDistribution[0.4], 10 ^ 5];EstimatedDistribution[data, BernoulliDistribution[p]]data = RandomVariate[ExponentialDistribution[3], 1000];EstimatedDistribution[data, ExponentialDistribution[λ]]DistributionFitTestを使ってフィットの質を調べる:
ℋ = DistributionFitTest[data, ExponentialDistribution[λ], "HypothesisTestData"]ℋ["FittedDistribution"]
ℋ[{"TestDataTable", All}]EstimatedDistributionはパラメトリック分布の母数を推定する:
data = RandomVariate[NormalDistribution[0, 1], 50];edist = EstimatedDistribution[data, NormalDistribution[μ, σ]]SmoothKernelDistributionはノンパラメトリックカーネル密度推定を与える:
skdist = SmoothKernelDistribution[data]ノンパラメトリック分布とパラメトリック分布の確率密度関数を比較する:
Plot[{PDF[skdist, x], PDF[edist, x]}, {x, -3, 3}, PlotStyle -> Thick]SmoothHistogramを使ってノンパラメトリック密度を可視化する:
SmoothHistogram[data, PlotStyle -> Thick]EstimatedDistributionは母数の最尤度推定を与える:
data = RandomVariate[GammaDistribution[4, 10], 25];edist = EstimatedDistribution[data, GammaDistribution[α, β]]Likelihoodを使って尤度を計算する:
Likelihood[edist, data]LogLikelihoodを使って対数尤度を計算する:
LogLikelihood[edist, data]data = RandomVariate[BetaDistribution[2, 5], 100];edist = EstimatedDistribution[data, BetaDistribution[α, β], ParameterEstimator -> "MethodOfMoments"]Momentを使ってデータから原点の周りのモーメントを計算する:
{Moment[data, 1], Moment[data, 2]}{Moment[edist, 1], Moment[edist, 2]}data = RandomVariate[WeibullDistribution[3, 15], 100];edist = EstimatedDistribution[data, WeibullDistribution[α, β]]QuantilePlotを使って経験的変位値とフィットされた分布変位値を可視化する:
QuantilePlot[data, edist]QuantilePlot内で推定した場合について同じ可視化を行う:
QuantilePlot[data, WeibullDistribution[α, β]]EstimatedDistributionは,TimeSeriesとEventSeriesのタイムスタンプを無視する:
ts = TemporalData[TimeSeries, {{{1, 0, 1, 0, 0, 1, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 0, 1, 0, 0, 1,
    0, 1, 0, 1, 0, 0, 0, 1, 0, 1, 0, 1, 0, 0, 1, 0, 0, 1, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 0,
    0, 0, 0, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 0, 1, 1, 0, 0, 0, 0, 0, 0, 1, 0, 1, 0, 1, 1, 1, 0, 0,
    1, 0, 0, 0, 1, 1, 1, 0, 1, 1, 1, 1}}, {{0, 99, 1}}, 1, {"Continuous", 1}, {"Discrete", 1}, 1,
{ResamplingMethod -> {"Interpolation", InterpolationOrder -> 1}}}, False, 10.1];EstimatedDistribution[ts, BernoulliDistribution[p]]EstimatedDistribution[ts["Values"], BernoulliDistribution[p]]TemporalDataについては,すべての経路構造が無視される:
td = TemporalData[«4»];EstimatedDistribution[td, NormalDistribution[a, b]]EstimatedDistribution[td["ValueList"]//Flatten, NormalDistribution[a, b]]考えられる問題 (3)
モーメント法による方程式の解は有効ではない母数を与えることがある:
EstimatedDistribution[{10, 12, 8, 15}, BinomialDistribution[n, p], ParameterEstimator -> "MethodOfMoments"]DistributionParameterQ[%]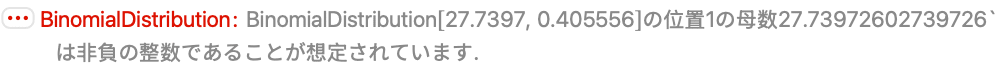
data = RandomVariate[NormalDistribution[-1, .1], 10 ^ 3];EstimatedDistribution[data, NormalDistribution[m, m], ParameterEstimator -> "MethodOfMoments"]DistributionParameterQ[%]
data = {4.1, 5.8, 4.3, 5.6, 3.8, 2.5, 3.1, 5.3, 5.4, 3.3};EstimatedDistribution[data, RiceDistribution[.01, α, β], ParameterEstimator -> "MethodOfMoments"]
EstimatedDistribution[data, RiceDistribution[.01, α, β], {{α, 4}, {β, .02}}, ParameterEstimator -> "MethodOfMoments"]data = RandomVariate[DirichletDistribution[Range[25]], 10 ^ 4];EstimatedDistribution[data, DirichletDistribution[Array[g, 25]]]//TimingEstimatedDistribution[data, DirichletDistribution[Array[g, 25]], Transpose[{Array[g, 25], Range[25]}]]//Timingテキスト
Wolfram Research (2010), EstimatedDistribution, Wolfram言語関数, https://reference.wolfram.com/language/ref/EstimatedDistribution.html.
CMS
Wolfram Language. 2010. "EstimatedDistribution." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/EstimatedDistribution.html.
APA
Wolfram Language. (2010). EstimatedDistribution. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/EstimatedDistribution.html