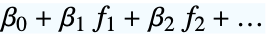




LinearModelFit
LinearModelFit[{{x1,y1},{x2,y2},…},{f1,f2,…},x]
連続する xiの値に対して yiをフィットする 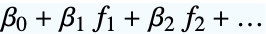 の形の線形モデルを構築する.
LinearModelFit[data,{f1,f2,…},{x1,x2,…}]
fiが変数 xkに依存する線形モデルを構築する.
LinearModelFit[{m,v}]
計画行列 m と応答ベクトル v から線形モデルを構築する.
詳細とオプション
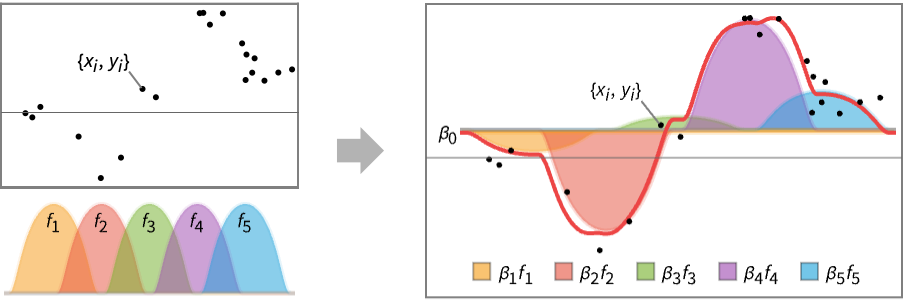
- LinearModelFitは,関数の線形結合を使って入力データをモデル化しようとする.
- LinearModelFitは,もとの
 が平均
 で共通標準偏差を持つ独立正規分布に従うという仮定の下に,
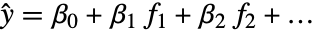 の形式の線形モデルを作成する.
- LinearModelFitは,構築する線形モデルを表す記号FittedModelオブジェクトを返す.
- 特定の点 x1, …におけるLinearModelFitからの最もよくフィットした関数の値は model[x1,…]で得ることができる.
- 次は,data の可能な形である.
-
{y1,y2,…} {{1,y1},{2,y2},…}という形式に等しい {{x11,x12,…,y1},…} 独立した値 xijと応答 yiのリスト {{x11,x12,…}y1,…} 入力値と応答の間の規則のリスト {{x11,x12,…},…}{y1,y2,…} 入力値と応答のリストの間の規則 {{x11,…,y1,…},…}n 行列の第 n 列をフィットする Tabular[…]name 表形式オブジェクト内の列 name をフィットする  のような多変量のデータの場合,座標 xi1, xi2, …の数は変数 xiの数と一致しなければならない.
- データ点は近似実数でよい.不確かさはAroundを使って指定できる.
- さらに,data は,関数および変数を指定しなくても計画行列を使って指定できる.
-
{m,v} 計画行列 m と対応ベクトル v - LinearModelFit[{m,v }]の計画行列 m は,{{f1,f2,…},{f1,f2,…},…}形のデータ点における基底関数 fiの値によって形成される.応答ベクトル v は応答のリスト{y1,y2,…}である.
- 計画行列が使われるとき,基底関数 fiはLinearModelFit[{m,v},{f1,f2,…}]の形を使って指定できる.
- 計画行列 m と応答ベクトル v についてのモデルは
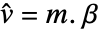 である.ここで,
 は推定すべきパラメータのベクトルである.
- LinearModelFitで使用可能なオプション
-
ConfidenceLevel 95/100 母数と予測の信頼水準 IncludeConstantBasis True 定数基底関数を入れるかどうか LinearOffsetFunction None 線形予測器における既知のオフセット NominalVariables None 名義的あるいはカテゴリ的とみなされる変数 VarianceEstimatorFunction Automatic 誤差分散の推定のための関数 Weights Automatic データ要素の重み WorkingPrecision Automatic 内部計算で使う精度 - 設定をIncludeConstantBasis->Falseとすると,
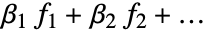 の形式のモデルがフィットされる.入力で計画行列が指定された場合は,オプションIncludeConstantBasisは無視される.
- LinearOffsetFunction->h と設定すると,
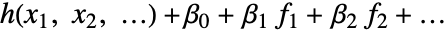 の形式のモデルがフィットされる.
- ConfidenceLevel->p のとき,確率 p の信頼区間は母数と予測区間に基づいて計算される.
- Weights->{w1,w2,…}と設定すると,yiの誤差分散は
 に比例すると考えられる.
- Weights->Automaticの設定でデータが厳密値を含んでいるときは,重みが1に設定される.データにAround値が含まれているなら,重みは
 に設定される.ただし,
 は応答分散の合計である.
- 応答分散の合計
 は,初期応答分散 si2と独立値の分散
 の関数である.
-
 はAroundReplaceを使ってモデル内を伝播し,結果の分散が応答分散 si2に加えられる.関数FindRootを内部的に使ってFasanoおよびVioのメソッドに従った自己矛盾しない解が求められる.
- VarianceEstimatorFunction->f と設定すると,分散は f[res,w]で予測される.ただし res={y1-
 ,y2-
 ,…}は剰余のリスト,w={w1,w2,…}は測定 yiの加重リストである.
- VarianceEstimatorFunction->(1&)およびWeights->{1/Δy12,1/Δy22,…}を使うと,Δyiは測定yiの既知の不確実性として扱われ,母数標準誤差は事実上加重のみから計算される.
- FittedModelのデータと診断は model["property"]で得ることができる.
- データと model["property"]を使って得られたフィットされた関数に関連する特性
-
"BasisFunctions" 基底関数のリスト "BestFit" フィットされた関数 "BestFitAround" フィットされた関数と平均不確実性 "BestFitDataAround" フィットされた関数とデータの不確実性 "BestFitParameters" 母数推定 "Data" 入力データあるいは計画行列と応答ベクトル "DesignMatrix" モデルの計画行列 "Function" 最もよくフィットした純関数 "Response" 入力データの応答値 "Weights" データのフィットに使われる重み - 残差のタイプ
-
"FitResiduals" 実際の応答と予測された応答の差 "StandardizedResiduals" 各残差について標準誤差で割られたフィットの残差 "StudentizedResiduals" 単一の削除誤差推定で割られたフィットの残差 - 平方誤差の総和に関連する特性
-
"ANOVA" 分散データの解析 "CoefficientOfVariation" 応答平均で割られた推定標準偏差 "EstimatedVariance" 誤差分散の推定 "PartialSumOfSquares" 非定数基底関数が除去されるときのモデル平方和の変化 "SequentialSumOfSquares" 要素ごとに区切られたモデル平方和 - 母数推定の特性と診断
-
"CorrelationMatrix" 母数相関行列 "CovarianceMatrix" 母数共分散行列 "Eigenstructure" 母数相関行列の固有構造 "ParameterEstimates" フィットされた母数情報の表 "VarianceInflationFactors" 推定母数の拡大要因のリスト - 影響力の統計量関連特性
-
"BetaDifferences" 母数値の影響のDFBETAS尺度 "CatcherMatrix" キャッチャー行列 "CookDistances" クック(Cook)の距離のリスト "CovarianceRatios" 観察影響のCOVRATIO尺度 "DurbinWatsonD" 自己相関のDurbin–Watson  統計
"FitDifferences" 予測値に対する影響のDFFITS尺度 "FVarianceRatios" 観察影響のFVARATIO尺度 "HatDiagonal" ハット行列の対角要素 "SingleDeletionVariances"  番目のデータ点を除いた分散推定のリスト
- 予測値関連特性
-
"MeanPredictionBands" 平均予測の信頼帯 "MeanPredictions" 平均予測の信頼区間 "PredictedResponse" データのフィットされた値 "SinglePredictionBands" 1回の観察に基づいた信頼帯 "SinglePredictions" 1回の観察の予想される応答の信頼区間 - 適合度の尺度特性
-
"AdjustedRSquared" モデル母数の数に適応された 
"AIC" 赤池情報量基準 "AICc" 有限サンプル修正AIC "BIC" ベイズ(Bayes)情報量基準 "RSquared" 決定係数 
- 特性の"BestFit","BestFitAround","BestFitDataAround","BestFitDataAround"および"MeanPredictionBands"は,特定の独立した値でこれらの特k性を評価するために{"prop",x}または{"prop",{x1,x2,…}}として呼び出すこともできる.
- 特性"RSquared"と"AdjustedRSquared"については,平方和の合計の計算は,一定の基準が含まれている場合にのみ平均値補正される.
データ
オプション
特性
例題
すべて開く すべて閉じる例 (2)
lm = LinearModelFit[{...}, x, x]lm[2.3]Show[ListPlot[lm["Data"]], Plot[lm[x], {x, 0, 5}], Frame -> True]lm = LinearModelFit[{...}, {x, y, x y}, {x, y}]Normal[lm]lm["FitResiduals"]スコープ (18)
データ (8)
増加する整数独立値を仮定して,1変数のモデルをフィットする:
LinearModelFit[{-0.8, -0.2, 0.8, 2.2}, x, x]LinearModelFit[{{1, -0.8}, {2, -0.2}, {3, 0.8}, {4, 2.2}}, x, x]応答が最後のものだと仮定して,2つ以上の変数を持つモデルをフィットする:
LinearModelFit[{{1, 1, Sin[2]}, {1, 2, Sin[3]}, {1, 3, Sin[4]}, {2, 1, Sin[3]}, {2, 2, Sin[4]}, {2, 3, Sin[5]}}, {x, y}, {x, y}]LinearModelFit[{{1, 1, Sin[2]}, {1, 2, Sin[3]}, {1, 3, Sin[4]}, {2, 1, Sin[3]}, {2, 2, Sin[4]}, {2, 3, Sin[5]}} -> -1, {x, y}, {x, y}]LinearModelFit[{{1, 1, Sin[2]}, {1, 2, Sin[3]}, {1, 3, Sin[4]}, {2, 1, Sin[3]}, {2, 2, Sin[4]}, {2, 3, Sin[5]}} -> 2, {x, y}, {x, y}]LinearModelFit[{{1, 1} -> 2, {2, 2} -> 3, {3, 1} -> 6, {3, 2} -> 5}, {x, y}, {x, y}]LinearModelFit[{1, 2, 3, 4, 5} -> {4, 4, 2, -2, -8}, {1, x ^ 2}, {x}]nom = LinearModelFit[{{a, 1}, {b, 2}, {a, 1.8}, {b, 2.5}}, x, x, NominalVariables -> x]LinearModelFit[{{{1, 1}, {1, 2}, {1, 3}, {1, 4}}, {1, 3, 6, 10}}]LinearModelFit[{{{1, 1}, {1, 2}, {1, 3}, {1, 4}}, {1, 3, 6, 10}}, {x, y}]応答列を指定してTabularオブジェクトをフィットする:
LinearModelFit[Tabular[Association["RawSchema" -> Association["ColumnProperties" ->
     Association["a" -> Association["ElementType" -> "Real64"],
      "b" -> Association["ElementType" -> "Real64"],
      "c" -> Association["ElementType" -> "Real64"]], "KeyColumns" -> None,
    "Backend" -> "WolframKernel"], "BackendData" ->
   Association["ColumnData" -> DataStructure["ColumnTable",
      {{TabularColumn[Association["Data" -> {{1., 1., 1., 2., 2., 2.}, {}, None},
          "ElementType" -> "Real64"]], TabularColumn[Association[
          "Data" -> {{1., 2., 3., 1., 2., 3.}, {}, None}, "ElementType" -> "Real64"]],
        TabularColumn[Association["Data" -> {{0.9092974268256817, 0.1411200080598672,
             -0.7568024953079283, 0.1411200080598672, -0.7568024953079283, -0.9589242746631385},
            {}, None}, "ElementType" -> "Real64"]]}}]]]] -> "c", {x, Cos[y]}, {x, y}]
モデル (3)
data = Table[{x, .3Tanh[x]}, {x, 10}];LinearModelFit[data, Tanh[x], x, IncludeConstantBasis -> False]data = Flatten[Table[{x, y, 3x - .2y + .5}, {x, 5}, {y, 5}], 1];LinearModelFit[data, {x, y}, {x, y}]LinearModelFit[data, {1, x, y}, {x, y}]data = Flatten[Table[{x, y, Sin[x + y]}, {x, 5}, {y, 5}], 1];LinearModelFit[data, {1, Sin[x], Cos[y]}, {x, y}]特性 (7)
データとフィットされた関数 (1)
data = Block[{i, j}, Table[{i = RandomReal[10], j = RandomReal[10], 4i + 2j + RandomReal[]}, {10}]];
lm = LinearModelFit[data, {x, y}, {x, y}]lm["Properties"]lm["Data"]fit = lm["BestFit"]Show[Plot3D[fit, {x, 0, 10}, {y, 0, 10}, PlotRange -> All], Graphics3D[{PointSize[0.025], Point[data]}]]lm[{"BestFit", {2., 5.}}]lm["Function"]MatrixForm /@ lm[{"DesignMatrix", "Response"}]残差 (1)
lm = LinearModelFit[RandomReal[10, {100, 3}], {x, y}, {x, y}]{fr, sr1, sr2} = lm[{"FitResiduals", "StandardizedResiduals", "StudentizedResiduals"}];ListPlot[fr]Map[ListPlot[#, Filling -> 0]&, {sr1, sr2}]//RowListPlot[Abs[sr1 - sr2]]平方和 (1)
SeedRandom[1];
data = Flatten[Table[{x, y, .2 + .3x + .1y + RandomReal[{-1, 1}]}, {x, RandomReal[5, 10]}, {y, RandomReal[5, 10]}], 1];lm = LinearModelFit[data, {x, y}, {x, y}]lm[{"EstimatedVariance", "CoefficientOfVariation"}]lm["ANOVA"]lm["ANOVA"][All, "FStatistics"]//DeleteMissing//Normal母数推定診断 (1)
SeedRandom[1];
data = Table[{x, .2 + .3x + .1Sin[x] + RandomReal[{-.2, .2}]}, {x, RandomReal[5, 100]}];lm = LinearModelFit[data, {x, Sin[x], Cos[x]}, x]lm["ParameterEstimates"]
lm["ParameterEstimates"][All, "TStatistic"]//Normal影響力の統計量 (1)
SeedRandom[1];
data = Table[{i, 2 + 4i - Log[i] + RandomReal[]}, {i, RandomReal[{1, 10}, 20]}];
data[[{3, 8}, -1]] = data[[{3, 8}, -1]] + 5;
lm = LinearModelFit[data, {x, Log[x]}, x]
1点を除いた分散を使って各点を除いた場合の誤差分散に対するインパクトをチェックする:
ListPlot[lm["SingleDeletionVariances"], PlotRange -> {0, All}, Filling -> 0]高影響点を見付けるためにクック(Cook)距離をチェックする:
ListPlot[lm["CookDistances"], PlotRange -> {0, All}, Filling -> 0]DFFITS値を使ってフィットされた値の各点の影響を評価する:
ListPlot[lm["FitDifferences"], PlotRange -> All, Filling -> 0]DFBETAS値を使って各推定母数上の各点の影響をチェックする:
MapThread[ListPlot[#1, PlotRange -> {-.5, 1}, Filling -> 0, PlotLabel -> #2]&, {Transpose[lm["BetaDifferences"]], {"SubscriptBox[β, 1]", "SubscriptBox[β, 2]", "SubscriptBox[β, 3]"}}]//Row予測値 (1)
SeedRandom[1];
data = Flatten[Table[{x, y, 3Exp[-x] + 1.2y + RandomReal[{-1, 1}]}, {x, RandomReal[5, 3]}, {y, RandomReal[5, 3]}], 1];lm = LinearModelFit[data, {Exp[-x], y}, {x, y}]ListPlot[Transpose[lm[{"Response", "PredictedResponse"}]], FrameLabel -> {"observed", "predicted"}, Frame -> True, Axes -> False]lm["MeanPredictions"]lm["SinglePredictions"]lm["SinglePredictions"][All, "ConfidenceInterval"]//Normallm["MeanPredictionBands", ConfidenceLevel -> .99]lm[{"MeanPredictionBands", {4., 1.}}, ConfidenceLevel -> .99]適合度尺度 (1)
data = Flatten[Table[{i, j, RandomReal[10], 30i - 10j + RandomReal[5]}, {i, RandomReal[10, 5]}, {j, RandomReal[10, 5]}], 1];lm = LinearModelFit[data, {x, y, z}, {x, y, z}]Grid[Transpose[{#, lm[#]}&[{"AdjustedRSquared", "AIC", "BIC", "RSquared"}]], Alignment -> Left]sub = Table[Join[{i}, LinearModelFit[data, i, {x, y, z}][{"AdjustedRSquared", "RSquared", "AIC", "BIC"}]], {i, Subsets[{x, y, z}]}]
Grid[Join[{{"Model", "AdjustedRSquared", "RSquared", "AIC", "BIC"}}, SortBy[sub, -#[[3]]&]]]
Grid[Join[{{"Model", "AdjustedRSquared", "RSquared", "AIC", "BIC"}}, SortBy[sub, -#[[2]]&]]]一般化と拡張 (1)
オプション (11)
ConfidenceLevel (1)
data = {{0, 1}, {1, 0}, {3, 2}, {5, 4}};lm = LinearModelFit[data, x, x]lm["ParameterEstimates"][All, "ConfidenceInterval"]//Normallm = LinearModelFit[data, x, x, ConfidenceLevel -> .99]lm["ParameterEstimates"][All, "ConfidenceInterval"]//NormalFittedModel内で水準を90%に設定する:
lm["ParameterEstimates", ConfidenceLevel -> .9][All, "ConfidenceInterval"]//NormalIncludeConstantBasis (1)
LinearOffsetFunction (1)
data = {{0, 1}, {1, 1.5}, {3, 2}, {5, 4}};LinearModelFit[data, x, x]//Normalデータを既知のSqrt[x]項がある線形モデルにフィットする:
LinearModelFit[data, x, x, LinearOffsetFunction -> (Sqrt[#]&)]//NormalNominalVariables (1)
data = {{a, 0, 1}, {b, 2, 2}, {a, 2, 1.8}, {b, 0, 2.5}};nom = LinearModelFit[data, {x, y}, {x, y}, NominalVariables -> x]Normal[nom]LinearModelFit[data, {x, y}, {x, y}, NominalVariables -> All]//NormalVarianceEstimatorFunction (1)
lm = LinearModelFit[Range[10] ^ 2, {x}, {x}]lm["EstimatedVariance"]lm["EstimatedVariance", VarianceEstimatorFunction -> (20&)]lm["EstimatedVariance", VarianceEstimatorFunction -> (Mean[# ^ 2]&)]Weights (5)
LinearModelFit[Range[10] ^ 2, x, x]//NormalLinearModelFit[Range[10] ^ 2, x, x, Weights -> 1 / Range[10]]//NormalAroundの値を使ってデータ点に異なる重みを与える:
data = {Around[1, 0.2], Around[2, 0.1], Around[4, 2]};
fit = LinearModelFit[data, x, x, Weights -> Automatic]Show[Plot[fit[x], {x, 0, 3}], ListPlot[data], PlotRange -> All]fit["Weights"]Aroundの値を独立変数と応答の両方に使う:
SeedRandom[1];
data = Table[
	{Around[x, RandomReal[0.25]], Around[2x ^ 2 - x + 0.3 + RandomReal[{-0.1, 0.1}], RandomReal[0.25]]},
	{x, -1, 1, 0.2}
	];
fit = LinearModelFit[data, {1, x, x ^ 2}, x, Weights -> Automatic]//NormalShow[Plot[fit, {x, -1, 1}], ListPlot[data], PlotRange -> All, AxesOrigin -> 0]Aroundの値の複数の変数を持つモデルをフィットする:
SeedRandom[1];
data = Join@@Table[
	{Around[x, RandomReal[0.25]], Around[y, RandomReal[0.25]], Around[2x ^ 2 - x + x y    + y ^ 2 + RandomReal[{-0.1, 0.1}], RandomReal[0.25]]},
	{x, -1, 1, 0.2},
	{y, -1, 1, 0.2}
	];
fit = LinearModelFit[data, {1, x, x ^ 2, y, y ^ 2, x y}, {x, y}, Weights -> Automatic]//NormalFixedPointアルゴリズムを使ってモデルの重みを求めてみる:
data = {...};
LinearModelFit[data, {1, x, x ^ 2, y, y ^ 2, x y}, {x, y}, Weights -> {Automatic, Method -> FixedPoint}]
減衰係数を小さくし,MaxIterationsを大きくすることで収束させる:
LinearModelFit[data, {1, x, x ^ 2, y, y ^ 2, x y}, {x, y},
	Weights -> {Automatic,
	Method -> {FixedPoint, DampingFactor -> 0.25, MaxIterations -> 200,
	Tolerance -> 10 ^ (-10)
	}
	}
	]
WorkingPrecision (1)
WorkingPrecision を使ってより高い精度の母数推定を得る:
data = Table[{x, x ^ 3}, {x, 10}]lm = LinearModelFit[data, {x, x ^ 2}, x, WorkingPrecision -> 50]lm["BestFit"]lm["BestFit", WorkingPrecision -> 20]アプリケーション (6)
lm = LinearModelFit[Array[Prime, 100], x, x]Show[ListPlot[lm["Data"], PlotStyle -> Orange], Plot[lm[x], {x, 0, 100}]]ListPlot[lm["FitResiduals"]]data = Map[{#[[1]], #[[2]], #[[3]], 1.2 + (3.7 + RandomReal[{-1, 1}])#[[1]] - 2#[[2]] + 23.4#[[3]]}&, RandomReal[10, {100, 3}]];lm = LinearModelFit[data, {x, y, z}, {x, y, z}]ListPlot[lm["FitResiduals"], Frame -> True, PlotRange -> All]Table[ListPlot[Transpose[{data[[All, i]], lm["FitResiduals"]}], Frame -> True, FrameLabel -> {{x, y, z}[[i]], "Residual"}], {i, 3}]//Rowてこ比を診断するためにクック(Cook)距離をプロットする:
cd = lm["CookDistances"];ListPlot[cd, Filling -> 0, Frame -> True, AxesOrigin -> {0, 0}, PlotRange -> All, PlotLabel -> "Cook's Distances"]Position[cd, _ ? (# > .05&)]Extract[data, %]

lm = LinearModelFit[RandomReal[10, {50, 4}], {x, y, z}, {x, y, z}]QuantilePlot[lm["StandardizedResiduals"], Table[InverseCDF[NormalDistribution[], q], {q, 1 / 100, 99 / 100, 1 / 50}]]QuantilePlot[lm["StudentizedResiduals"], Table[InverseCDF[NormalDistribution[], q], {q, 1 / 100, 99 / 100, 1 / 50}]]groups = {"control", "treatment 1", "treatment 2", "treatment 3"};
data = BlockRandom[SeedRandom[123];
Block[{vals, times, rand},
vals = RandomChoice[groups, 100];
times = RandomInteger[10, 100];
rand = RandomReal[1, 100];
Transpose[{vals, times, (vals /. Thread[Rule[groups, {.16, .34, .57, 1.1}]]) - .05 times + rand}]]];lm = LinearModelFit[data, {treatment, time}, {treatment, time}, NominalVariables -> treatment];lm["ANOVA"]grps = Drop[GatherBy[Sort[data], First], None, None, 1];Show[ListPlot[grps, PlotRange -> All], Plot[Evaluate[Map[lm[#, t]&, groups]], {t, 0, 10}, PlotLegends -> LineLegend[groups, LegendLayout -> "ReversedColumn"]]]SeedRandom[1];
data = Flatten[Table[{x, y, z, 1.2x - 3.4y + 10z + RandomReal[10]}, {x, RandomReal[10, 3]}, {y, RandomReal[10, 3]}, {z, RandomReal[10, 3]}], 2];lm = LinearModelFit[data, {x, y, z}, {x, y, z}]{desmat, resids} = lm[{"DesignMatrix", "FitResiduals"}];ホワイト(White)の不均一分散一致共分散推定を計算する:
(wc = With[{inv = Inverse[Transpose[desmat].desmat], xresid = resids * desmat},
inv.Transpose[xresid].xresid.inv])//MatrixFormlm["CovarianceMatrix"]//MatrixFormSqrt[Diagonal[wc]]lm["ParameterEstimates"][All, "StandardError"]//Normaldata = Flatten[Table[{x, y, z, 1.2x - 3.4y + 10z + RandomReal[10]}, {x, RandomReal[10, 3]}, {y, RandomReal[10, 3]}, {z, RandomReal[10, 3]}], 2];lm1 = LinearModelFit[data, {x, y, z}, {x, y, z}]lm2 = LinearModelFit[Block[{newdata = data}, newdata[[All, -1]] = lm1["FitResiduals"] ^ 2;newdata], {x, y, z}, {x, y, z}]bp = With[{sqResids = lm1["FitResiduals"] ^ 2}, (Variance[sqResids](Length[data] - 1) - Total[lm2["FitResiduals"] ^ 2]) / 2 / (Total[sqResids] / Length[data]) ^ 2]
1 - CDF[ChiSquareDistribution[Length[lm1["BestFitParameters"]] - 1], bp]特性と関係 (10)
DesignMatrixはLinearModelFitで使われる計画行列を構築する:
data = Table[{i, RandomReal[]}, {i, 5}]DesignMatrix[data, x, x]//MatrixFormlm = LinearModelFit[data, x, x];lm["DesignMatrix"]//MatrixFormデフォルトで,LinearModelFitとGeneralizedLinearModelFitは同じモデルをフィットする:
data = Table[{i, RandomReal[{i - 1, i}]}, {i, 10}];LinearModelFit[data, x, x]GeneralizedLinearModelFit[data, x, x]LinearModelFitは正規分布した誤差を想定して線形モデルをフィットする:
data = Table[{i, RandomReal[{i - 1, i}]}, {i, 10}];LinearModelFit[data, x ^ 2, x]NonlinearModelFitは正規分布した誤差を想定して非線形モデルをフィットする:
NonlinearModelFit[data, a Exp[b x], {a, b}, x]FitとLinearModelFitは等しいモデルをフィットする:
data = Table[{i, RandomReal[{i - 1, i}]}, {i, 10}];Fit[data, {1, x ^ 2}, x]lm = LinearModelFit[data, x ^ 2, x]LinearModelFitはフィットに関する追加的な情報を除去することを許す:
lm["FitResiduals"]data = Flatten[Table[{i, j, i + j + Exp[i - j] + RandomReal[2]}, {i, 5}, {j, 5}], 1];LinearModelFit[data, {x, y, Exp[x - y]}, {x, y}]["BestFitParameters"]dm = DesignMatrix[data, {x, y, Exp[x - y]}, {x, y}];
resp = data[[All, -1]];LinearModelFit[{dm, resp}]["BestFitParameters"]LeastSquaresを介して母数推定を得る:
LeastSquares[dm, resp]LinearModelFitは線形モデルをフィットする:
data = Table[{i, i}, {i, 10}];LinearModelFit[data, {x ^ 2, Sin[x]}, x]["BestFitParameters"]FindFitは線形モデルおよび非線形モデルの母数推定を与える:
FindFit[data, a + b x ^ 2 + c Sin[x], {a, b, c}, x]LinearModelFitは,TimeSeriesのタイムスタンプを変数として使う:
ts1 = TemporalData[TimeSeries, {{{1.102448341846048, 6.331833897009389, 7.5843632999043455,
    44.59969789743589, 98.76273258351092, 150.00729051003992, 644.7367359379259,
    1724.3968817536402, 5903.697723461762, 19468.09340765025}}, {{0, 9, 1}}, 1, {"Continuous", 1},
  {"Discrete", 1}, 1, {ResamplingMethod -> {"Interpolation", InterpolationOrder -> 1}}}, False,
10.1];ts1["Times"]base = {1, x, Exp[x]};LinearModelFit[ts1, base, x]ts2 = TimeSeriesRescale[ts1, {.1, 2}]ts2["Times"]LinearModelFit[ts2, base, x]LinearModelFit[ts1["Values"], base, x]LinearModelFitは,複数の経路のあるTemporalDataについては,経路ごとに作用する:
LinearModelFit[TemporalData[Automatic, {{{1.102448341846048, 6.331833897009389, 7.5843632999043455,
    44.59969789743589, 98.76273258351092, 150.00729051003992, 644.7367359379259,
    1724.3968817536402, 5903.697723461762, 19468.09340765025},
   {1.1024483418 ... 7359379259, 1724.3968817536402, 5903.697723461762,
    19468.09340765025}}, {{0, 9, 1}, {0.1, 2., 0.2111111111111111}}, 2, {"Continuous", 2},
  {"Discrete", 2}, 1, {ResamplingMethod -> {"Interpolation", InterpolationOrder -> 1}}}, False,
10.1], {1, x, Exp[x]}, x]LinearModelFit[{{0, 1}, {1, 0}, {3, 2}, {5, 4}}, x, x]%[2.3]単一の線形層があるニューラルネットを使って同じフィットを行う:
NetTrain[LinearLayer[], Rule@@@{{0, 1}, {1, 0}, {3, 2}, {5, 4}}]%[2.3]data = {{0, 1}, {1, 0}, {2, 1}, {3, 2}, {5, 4}};
n = Length[data];
basis = {1, x};
k = Length[basis] + 1; (* +1 for the estimation of the variance *)
lm = LinearModelFit[data, basis, x];
lm["AIC"]errorSumOfSquares = Total[lm["FitResiduals"] ^ 2];
varianceMLE = errorSumOfSquares / n;
logLike = (-1 / 2) * (n * Log[2Pi * varianceMLE] +
errorSumOfSquares / varianceMLE);
aic = 2 * k - 2 * logLikelm["AICc"] == aic + (2k * (k + 1)) / (n - k - 1)lm["BIC"] == Log[n] * k - 2 * logLike
responses = data[[All, 2]];
lm["RSquared"]1 - Total[lm["FitResiduals"] ^ 2] / Total[(responses - Mean[responses]) ^ 2]モデルに定数基底が含まれていない場合,分母は平均調整されない:
lm2 = LinearModelFit[data, {x}, x, IncludeConstantBasis -> False];
lm2["RSquared"]1 - Total[lm2["FitResiduals"] ^ 2] / Total[responses ^ 2]テキスト
Wolfram Research (2008), LinearModelFit, Wolfram言語関数, https://reference.wolfram.com/language/ref/LinearModelFit.html (2025年に更新).
CMS
Wolfram Language. 2008. "LinearModelFit." Wolfram Language & System Documentation Center. Wolfram Research. Last Modified 2025. https://reference.wolfram.com/language/ref/LinearModelFit.html.
APA
Wolfram Language. (2008). LinearModelFit. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/LinearModelFit.html