

DistributionFitTest
DistributionFitTest[data]
检验 data 是否为正态分布.
DistributionFitTest[data,dist]
检验 data 是否服从分布 dist.
DistributionFitTest[data,dist,"property"]
返回 "property" 的值.
更多信息和选项
- DistributionFitTest 进行拟合优度假设检验,其中零假设
 假定 data 是从一个服从分布 dist 的总体中抽取的,而备择假设
 认为并非如此.
- 默认情况下,返回一个概率值或者
 值.
- 一个较小的
 值表明 data 不可能来自 dist.
- dist 可以是任何带有数值型或者符号型参数的符号式分布,也可以是一个数据集.
- data 可以是单变量 {x1,x2,…} 或者多变量 {{x1,y1,…},{x2,y2,…},…}.
- DistributionFitTest[data,dist,Automatic] 将选择对于一般备择假设而言,适用于 data 和 dist 的最有效的检验.
- DistributionFitTest[data,dist,All] 将选择适用于 data 和 dist 的所有检验.
- DistributionFitTest[data,dist,"test"] 根据 "test" 的结果报告
 值.
- 许多检验使用的是所检验分布 dist 的累积分布函数
 ,数据的经验累积分布函数
 ,以及两者的差值
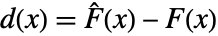 和
 =Expectation[d(x),…]. 累积分布函数
 和
 在零假设
 下应该是相同的.
- 下列检验可以用于单变量以及多变量分布:
-
"AndersonDarling" 分布,数据 基于 Expectation[ 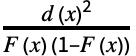 ]
"CramerVonMises" 分布,数据 基于 Expectation[d(x)2] "JarqueBeraALM" 正态性 基于偏度和峰度 "KolmogorovSmirnov" 分布,数据 基于 
"Kuiper" 分布,数据 基于 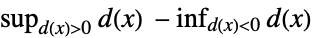
"PearsonChiSquare" 分布,数据 基于期望直方图和观测到的直方图 "ShapiroWilk" 正态性 基于分位数 "WatsonUSquare" 分布,数据 基于 Expectation[ 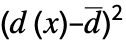 ]
- 下列检验可用于多变量分布:
-
"BaringhausHenze" 正态性 基于经验特征函数 "DistanceToBoundary" 均匀性 基于到均匀边界的距离 "MardiaCombined" 正态性 组合的 Mardia 偏度和峰度 "MardiaKurtosis" 正态性 基于多变量峰度 "MardiaSkewness" 正态性 基于多变量偏度 "SzekelyEnergy" 数据 基于牛顿势能 - DistributionFitTest[data,dist,"property"] 可以直接给出 "property" 的值.
- 与检验结果报告相关的属性包括:
-
"AllTests" 所有适用的检验列表 "AutomaticTest" 使用 Automatic 时所选择的检验 "DegreesOfFreedom" 检验中所用的自由度 "PValue"  值的列表
"PValueTable"  值的格式化表格
"ShortTestConclusion" 检验结果的简短描述 "TestConclusion" 检验结论的描述 "TestData" 检验统计量和  值的成对列表
"TestDataTable"  值和检验统计量的格式化表格
"TestStatistic" 检验统计量的列表 "TestStatisticTable" 检验统计量的格式化表格 "HypothesisTestData" 返回一个 HypothesisTestData 对象 - DistributionFitTest[data,dist,"HypothesisTestData"] 返回一个 HypothesisTestData 对象 htd,该对象可用于提取其它检验结果,并利用形式 htd["property"] 获得各属性.
- 与数据分布相关的属性有:
-
"FittedDistribution" 数据的拟合分布 "FittedDistributionParameters" 数据的分布参数 - 可以给出下列选项:
-
Method Automatic 计算  值所用的方法
SignificanceLevel 0.05 诊断与报告的临界值 - 对于拟合优度检验,选择一个临界值
 使得
 仅当
 时被拒绝. 用于 "TestConclusion" 和 "ShortTestConclusion" 属性的
 值由 SignificanceLevel 选项控制. 默认情况下,
 设为 0.05.
- 在设置 Method->"MonteCarlo" 下,使用拟合分布在
 的条件下,生成与输入 si 长度相同的
 个数据集合. 然后,使用来自 DistributionFitTest[si,dist,{"TestStatistic",test}] 的 EmpiricalDistribution 估计
 值.
范例
打开所有单元 关闭所有单元基本范例 (3)
data = RandomVariate[NormalDistribution[], 2500];DistributionFitTest[data]创建一个 HypothesisTestData 对象,以进一步提取属性:
ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];ℋ["TestDataTable", All]Show[Histogram[data, Automatic, "ProbabilityDensity"], Plot[PDF[ℋ["FittedDistribution"], x], {x, -5, 5}, PlotStyle -> Thick]]data = RandomVariate[𝒹 = ParetoDistribution[1, 2], 100];DistributionFitTest[data, 𝒹, {"TestDataTable", "AndersonDarling"}]用 ProbabilityPlot 验证检验结果:
ProbabilityPlot[data, 𝒹]data = RandomVariate[𝒟 = BinormalDistribution[.5], 100];ℋ = DistributionFitTest[data, 𝒟, "HypothesisTestData"];ℋ["TestDataTable", "KolmogorovSmirnov"]绘制检验分布的边缘概率分布函数相对于数据的图形,以验证检验结果:
Table[Show[SmoothHistogram[data[[All, i]], PlotStyle -> {Orange, Dashed}, PlotRange -> {0, .4}], Plot[PDF[MarginalDistribution[𝒟, i], x], {x, -4, 4}]], {i, 2}]范围 (22)
检验 (16)
data1 = RandomVariate[NormalDistribution[], 500];
data2 = RandomVariate[StudentTDistribution[5], 500];
DistributionFitTest[data1]
DistributionFitTest[data2]设定 Automatic 的第三个参数,以应用一般意义上较有效且适当的检验:
data = RandomVariate[NormalDistribution[], 10^4];DistributionFitTest[data]属性 "AutomaticTest" 可用于确定检验的类型:
DistributionFitTest[data, Automatic, "AutomaticTest"]data = RandomVariate[WeibullDistribution[1, 2], 10^3];DistributionFitTest[data, WeibullDistribution[1, 2]]这里没有足够的证据来拒绝这是 WeibullDistribution[1,2] 的良好拟合:
Show[Histogram[data, Automatic, "ProbabilityDensity"], Plot[PDF[WeibullDistribution[1, 2], x], {x, 0, 12}, PlotStyle -> Thick]]𝒟 = MixtureDistribution[{1 / 2, 1 / 2}, {NormalDistribution[-1, 2], ExponentialDistribution[1]}];data1 = RandomVariate[𝒟, 10^4];
data2 = RandomVariate[NormalDistribution[], 10^4];Show[Histogram[data1, Automatic, "PDF"], Plot[PDF[𝒟, x], {x, -5, 5}, PlotRange -> All, Axes -> {True, False}, PlotStyle -> Thick]]
DistributionFitTest[data1, 𝒟]DistributionFitTest[data2, 𝒟]data = QuantityArray[RandomVariate[NormalDistribution[100, 6], 100], "Centimeters"]DistributionFitTest[data, NormalDistribution[μ, σ]]DistributionFitTest[data, NormalDistribution[Quantity[1, "Meters"], Quantity[6, "Centimeters"]]]𝒟 = ProbabilityDistribution[Piecewise[{{x ^ 2 / 9, 0 < x ≤ 3}}], {x, -Infinity, Infinity}];data = BlockRandom[SeedRandom[2];RandomVariate[𝒟, 50]];Show[SmoothHistogram[data, PlotStyle -> Dotted], Plot[PDF[𝒟, x], {x, -5, 5}, PlotRange -> All, Axes -> {True, False}, PlotStyle -> {Orange, Thick}]]DistributionFitTest[data, 𝒟]data = RandomVariate[NormalDistribution[1, 2], 10^3];
Table[DistributionFitTest[data, NormalDistribution@@i], {i, {{1, 2}, {1, σ}, {μ, 2}, {μ, σ}}}]data1 = RandomVariate[BinormalDistribution[.5], 10^3];
data2 = RandomVariate[MultivariateTDistribution[IdentityMatrix[2], 15], 10^3];
Table[DistributionFitTest[data], {data, {data1, data2}}]data = RandomVariate[UniformDistribution[{{0, 1}, {0, 1}}], 10^3];分别检验 MultinormalDistribution 和多元 UniformDistribution:
Table[DistributionFitTest[data, 𝒟], {𝒟, {Automatic, UniformDistribution[{{0, 1}, {0, 1}}]}}]data1 = RandomVariate[NormalDistribution[], 10^3];
data2 = RandomVariate[NormalDistribution[], 10^3];DistributionFitTest[data1, data2]data3 = RandomVariate[NormalDistribution[], 10^2];DistributionFitTest[data1, data3]data1 = RandomVariate[BinormalDistribution[-.99], 10^2];
data2 = RandomVariate[BinormalDistribution[-.99], 10^2];
data3 = RandomVariate[BinormalDistribution[.99], 10^2];

DistributionFitTest[data1, data2]DistributionFitTest[data1, data3]data = RandomVariate[NormalDistribution[], 10^4];DistributionFitTest[data, Automatic, "AndersonDarling"]DistributionFitTest[data, Automatic, {"AndersonDarling", "KolmogorovSmirnov"}]data = RandomVariate[NormalDistribution[], 10^4];DistributionFitTest[data, Automatic, All]DistributionFitTest[data, Automatic, "AllTests"]创建一个 HypothesisTestData 对象以重复提取属性:
data = RandomVariate[NormalDistribution[], 10^4];ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];ℋ["Properties"]从一个 HypothesisTestData 对象中提取一些属性:
data = RandomVariate[NormalDistribution[], 10^4];ℋ = DistributionFitTest[data, NormalDistribution[], "HypothesisTestData"];
ℋ["PValue", "CramerVonMises"]ℋ["TestStatistic", "CramerVonMises"]data = RandomVariate[NormalDistribution[], 100];ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];Anderson–Darling 的  值和检验统计量的结果:
ℋ[{{"PValue", "AndersonDarling"}, {"TestStatistic", "AndersonDarling"}}]数据属性 (2)
data = RandomVariate[NormalDistribution[], 10^4];ℋ = DistributionFitTest[data, NormalDistribution[μ, σ], "HypothesisTestData"];ℋ["FittedDistributionParameters"]𝒟 = ℋ["FittedDistribution"]Show[Plot[PDF[𝒟, x], {x, -4, 4}], SmoothHistogram[data, PlotStyle -> {Dotted, Orange}]]ℋ["KolmogorovSmirnov"]data = RandomVariate[NormalDistribution[], 10^4];𝒟 = DistributionFitTest[data, NormalDistribution[0, 1], "FittedDistribution"]Show[Histogram[data, Automatic, "ProbabilityDensity"], Plot[PDF[𝒟, x], {x, -4, 4}, PlotStyle -> Thick]]报告 (4)
data = RandomVariate[NormalDistribution[], 10^3];ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];ℋ["TestDataTable"]ℋ["TestDataTable", All]ℋ["TestDataTable", {"AndersonDarling", "PearsonChiSquare"}]data = BlockRandom[SeedRandom[1];RandomVariate[NormalDistribution[], 10^3]];ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];res = ℋ["TestData", All]; 值高于 0.05,因此在该水平上没有足够的证据来拒绝分布的正态性:
Show[BarChart[res[[All, 2]], ChartLabels -> Placed[ℋ["AllTests"], Center], BarOrigin -> Left], Graphics[Line[{{.05, 0}, {.05, 11.5}}]]]
data = RandomVariate[NormalDistribution[], 10^4];ℋ = DistributionFitTest[data, Automatic, "HypothesisTestData"];ℋ["PValueTable", "CramerVonMises"]
ℋ["PValue", "CramerVonMises"]
ℋ["PValueTable", All]
ℋ["PValueTable", {"AndersonDarling", "CramerVonMises", "WatsonUSquare"}]data = RandomVariate[CauchyDistribution[1, 2], 10^3];ℋ = DistributionFitTest[data, CauchyDistribution[1, 2], "HypothesisTestData"];ℋ["TestStatisticTable"]ℋ["TestStatistic"]ℋ["TestStatisticTable", All]选项 (6)
Method (4)
data = RandomVariate[NormalDistribution[], 100];DistributionFitTest[data, NormalDistribution[], "CramerVonMises", Method -> "MonteCarlo"]DistributionFitTest[data, NormalDistribution[], "CramerVonMises", Method -> Automatic]data = RandomVariate[NormalDistribution[], 100];pts = Table[{i, DistributionFitTest[data, NormalDistribution[], "CramerVonMises", Method -> {"MonteCarlo", "MonteCarloSamples" -> i}]}, {i, Range[5, 1000, 50]}];
pval = DistributionFitTest[data, NormalDistribution[], "CramerVonMises"];Show[ListLinePlot[pts, PlotRange -> {0, 1}, FrameLabel -> {"Samples", "P-Value"}, Frame -> True, AxesOrigin -> {0, 0}], Graphics[{Dashed, Line[{{0, pval}, {1000, pval}}]}]]data = RandomVariate[NormalDistribution[], 100];pts = Table[{i, DistributionFitTest[data, NormalDistribution[], "CramerVonMises", Method -> {"MonteCarlo", "RandomSeed" -> i}]}, {i, Range[1, 10]}];
pval = DistributionFitTest[data, NormalDistribution[], "CramerVonMises"];Show[ListLinePlot[pts, PlotRange -> {Min[pts[[All, 2]]], Max[pts[[All, 2]]]}, FrameLabel -> {"Seed", "P-Value"}, Frame -> True, AxesOrigin -> {0, 0}], Graphics[{Dashed, Line[{{0, pval}, {100, pval}}]}]]
mcSamp = 250;seed = 9;n = 50;𝒟 = NormalDistribution[μ, σ];data = RandomVariate[NormalDistribution[1, 2], n];ℋ = DistributionFitTest[data, 𝒟, "HypothesisTestData", Method -> {"MonteCarlo", "MonteCarloSamples" -> mcSamp, "RandomSeed" -> seed}];simDat = BlockRandom[SeedRandom[seed];RandomVariate[ℋ["FittedDistribution"], {mcSamp, n}]];testDist = DistributionFitTest[#, 𝒟, "TestStatistic"]& /@ simDat;
SmoothHistogram[testDist, Filling -> Axis]
Probability[t > ℋ["TestStatistic"], tEmpiricalDistribution[testDist]]ℋ["PValue"]SignificanceLevel (2)
data = BlockRandom[SeedRandom[234];RandomVariate[NormalDistribution[0, 1], 100]];DistributionFitTest[data, Automatic, "TestConclusion"]//TraditionalFormDistributionFitTest[data, Automatic, "TestConclusion", SignificanceLevel -> 0.001]//TraditionalForm显著水平也用于 "ShortTestConclusion":
data = BlockRandom[SeedRandom[234];RandomVariate[NormalDistribution[0, 1], 100]];ℋ1 = DistributionFitTest[data, Automatic, "HypothesisTestData", SignificanceLevel -> .05];ℋ2 = DistributionFitTest[data, Automatic, "HypothesisTestData", SignificanceLevel -> .001];ℋ1["ShortTestConclusion"]ℋ2["ShortTestConclusion"]应用 (12)
data = {87, 91, 97 , 80, 71, 86, 72, 93, 83, 73, 76};
𝒹 = NormalDistribution[82, 9];ℋ = DistributionFitTest[data, 𝒹, "HypothesisTestData"];ℋ["TestDataTable"]在 QuantilePlot 中作图比较实验和理论累积分布函数:
QuantilePlot[data, 𝒹]Plot[{CDF[ℋ["FittedDistribution"], x], CDF[EmpiricalDistribution[data], x]}//Evaluate, {x, 50, 110}, Exclusions -> None, Filling -> {1 -> {2}}, Frame -> True]snow = ExampleData[{"Statistics", "BuffaloSnow"}];ℋ = DistributionFitTest[snow, Automatic, "HypothesisTestData"];使用 Jarque–Bera ALM 检验与 Shapiro–Wilk 检验来评定正态性:
ℋ["TestDataTable", {"JarqueBeraALM", "ShapiroWilk"}]SmoothHistogram 与检验结果相符:
Show[SmoothHistogram[snow, PlotStyle -> {Dotted, Orange}], Plot[PDF[ℋ["FittedDistribution"], x], {x, 0, 150}]]QuantilePlot 表明拟合效果相当好:
QuantilePlot[snow, ℋ["FittedDistribution"]]𝒹 = BetaDistribution[2, 2];
BlockRandom[SeedRandom[1];data = RandomVariate[𝒹, 10000]];Show[Histogram[data, Automatic, "ProbabilityDensity"], Plot[PDF[𝒹, x], {x, 0, 1}, PlotStyle -> Thick]]柯尔莫哥洛夫–斯米尔诺夫检验的结果与直方图一致,均表明拟合效果良好:
DistributionFitTest[data, 𝒹, "KolmogorovSmirnov"]data = EntityClass["Star", "StarBrightest100"]["AbsoluteMagnitude"];ℋ = DistributionFitTest[data, NormalDistribution[a, b], "HypothesisTestData"];ℋ["TestDataTable", Automatic]Show[SmoothHistogram[data, PlotStyle -> {Dotted, Orange}, PlotRange -> {0, .15}], Plot[PDF[ℋ["FittedDistribution"], x], {x, -15, 10}]]ExampleData[{"Statistics", "UgandaVolcanoes"}, "LongDescription"]data = ExampleData[{"Statistics", "UgandaVolcanoes"}];box1 = {{320, 2760}, {970, 4150}};
box2 = {{1100, 1800}, {1600, 3000}};Show[ListPlot[data, PlotRange -> {{200, 2800}, {500, 5000}}], Graphics[{EdgeForm[Orange], Opacity[0], Rectangle@@Transpose[box1]}], Graphics[{EdgeForm[Gray], Opacity[0], Rectangle@@Transpose[box2]}], AspectRatio -> 1, ImageSize -> Medium]DistributionFitTest[data, UniformDistribution[box1], {"TestDataTable", "DistanceToBoundary"}]DistributionFitTest[Pick[data, (Boole[1100 ≤ #1[[1]] ≤ 1800 && 1600 ≤ #1[[2]] ≤ 3000]&) /@ data, 1], UniformDistribution[box2], {"TestDataTable", "DistanceToBoundary"}]ExampleData[{"Statistics", "SwissBankNotes"}, "ColumnDescriptions"]data = ExampleData[{"Statistics", "SwissBankNotes"}];counterfeit = Pick[data[[All, 1 ;; 6]], data[[All, -1]], 1];
genuine = Pick[data[[All, 1 ;; 6]], data[[All, -1]], 0];DistributionFitTest[counterfeit, genuine, {"TestDataTable", "SzekelyEnergy"}]Table[SmoothHistogram[{counterfeit[[All, i]], genuine[[All, i]]}, PlotLabel -> Row[{"Measure:", i}]], {i, 6}]Subscript[rad, 1] = {1.77, 3.63, 5.21, 5.54, 0.17, 6.26, 2.84, 2.1, 5.73, 5.13, 2.30, 4.13, 3.56, 0.6, 0.99};Subscript[rad, 2] = {0.96, 0.83, 1.18, 0.97, 1.92, 1.99, 0.94, 0.89, 0.98, 1.33, 0.86, 0.58, 0.73, 1.85, 2.3};Kuiper 检验与 Watson  检验可以有效检验数据在圆上的均匀性:
Table[DistributionFitTest[i, UniformDistribution[{0, 2 Pi}], {"TestDataTable", {"Kuiper", "WatsonUSquare"}}], {i, {Subscript[rad, 1], Subscript[rad, 2]}}]Table[Show[Graphics[{StandardGray, Circle[]}], ListPlot[{Cos[#], Sin[#]}& /@ i, PlotStyle -> PointSize[.05]]], {i, {Subscript[rad, 1], Subscript[rad, 2]}}]sp500 = FinancialData["SP500", All];
data = Log[Ratios[sp500]]Histogram[data, PlotRange -> {{-.05, .05}, All}]尝试用 LaplaceDistribution:
ℋ = DistributionFitTest[data, LaplaceDistribution[a, b], "HypothesisTestData"];ℋ["TestDataTable", All]Show[SmoothHistogram[data, PlotStyle -> Orange, PlotRange -> {0, 2}], Plot[PDF[ℋ["FittedDistribution"], x], {x, Min[data], Max[data]}]]检验 LinearModelFit 的残差的正态性:
data = ExampleData[{"Statistics", "OldFaithful"}];lm = LinearModelFit[data, x, x];ℋ = DistributionFitTest[res = lm["FitResiduals"], Automatic, "HypothesisTestData"];ℋ["TestDataTable", "ShapiroWilk"]从 QuantilePlot 中可以看出在分布的左尾部有较大的偏差:
QuantilePlot[res, ℋ["FittedDistribution"]]
mcSamples = RandomVariate[𝒹 = NormalDistribution[], {2500, 25}];Subscript[ℋ, MC] = DistributionFitTest[#, 𝒹, "HypothesisTestData"]& /@ mcSamples;T = Table[i["TestStatistic", "AndersonDarling"], {i, Subscript[ℋ, MC]}];利用 SmoothHistogram 可视化检验统计量的分布:
SmoothHistogram[T, PlotLabel -> "A-D Distribution: n = 25", Filling -> Axis]获得 Anderson–Darling 检验的蒙特卡罗  值:
data = RandomReal[𝒹, 25];ℋ = DistributionFitTest[data, 𝒹, "HypothesisTestData"];t = ℋ["TestStatistic", "AndersonDarling"]Subscript[P, MC] = Length[Cases[T, x_ /; x > t]] / Length[T]//N与 DistributionFitTest 返回的  值比较:
ℋ["PValue", "AndersonDarling"] - Subscript[P, MC]data = Table[RandomVariate[StudentTDistribution[2], {500, i}], {i, n = {5, 7, 10, 15, 20, 25, 30, 40, 50}}];ℋ = Table[DistributionFitTest[data[[i, j]], NormalDistribution[], "ShapiroWilk"], {i, Length[data]}, {j, Length[data[[i]]]}];pC = Interpolation[Transpose[{n, Table[Probability[x ≤ 0.05, xi], {i, ℋ}]}], InterpolationOrder -> 1];Plot[pC[x], {x, 5, 50}, PlotRange -> {0, 1}, Ticks -> {n, Automatic}, AxesOrigin -> {0, 0}]估计 Shapiro–Wilk 检验的效能,其中底层分布为 StudentTDistribution[2],检验的尺寸为 0.05,且样本大小为 35:
pC[35]//N利用核密度估计对一个数据集进行平滑处理可以在保留数据的底层分布结构的同时,删除噪音. 下面的两个数据集是从同一个分布中创建的:
data1 = BlockRandom[SeedRandom[1];RandomVariate[NormalDistribution[], 100]];
data2 = BlockRandom[SeedRandom[14];RandomVariate[NormalDistribution[], 100]];Plot[Evaluate[CDF[EmpiricalDistribution[#], x]& /@ {data1, data2}], {x, -5, 5}, Exclusions -> None]DistributionFitTest[data1, data2]𝒟 = SmoothKernelDistribution[data2];Plot[{CDF[EmpiricalDistribution[data1], x], CDF[𝒟, x]}, {x, -5, 5}, Exclusions -> None]平滑处理可以降低噪声,并且在 5% 显著性水平上得到一个正确的结论:
DistributionFitTest[data1, 𝒟]属性和关系 (16)
默认情况下,单变量数据与 NormalDistribution 比较:
data = RandomVariate[CauchyDistribution[0, 1], 10];ℋ1 = DistributionFitTest[data, Automatic, "HypothesisTestData"];
ℋ2 = DistributionFitTest[data, NormalDistribution[μ, σ], "HypothesisTestData"];{ℋ1["FittedDistribution"], ℋ2["FittedDistribution"]}默认情况下,多变量数据与 MultinormalDistribution 比较:
data = RandomVariate[BinormalDistribution[.5], 10];ℋ1 = DistributionFitTest[data, Automatic, "HypothesisTestData"];
ℋ2 = DistributionFitTest[data, MultinormalDistribution[{μ1, μ2}, IdentityMatrix[2]], "HypothesisTestData"];{ℋ1["FittedDistribution"], ℋ2["FittedDistribution"]}//TraditionalFormdata = RandomVariate[ExponentialDistribution[3], 10^3];ℋ = DistributionFitTest[data, ExponentialDistribution[λ], "FittedDistribution"]EstimatedDistribution[data, ExponentialDistribution[λ]]
data = RandomVariate[NormalDistribution[], {1000, 10}];pvals = Table[DistributionFitTest[i, NormalDistribution[], "CramerVonMises"], {i, data}];设置检验的大小为 0.05 将导致有5%的概率会错误否定  :
Probability[x ≤ 0.05, xpvals]//N
data = RandomVariate[CauchyDistribution[0, 1], {1000, 25}];ℋs = Table[DistributionFitTest[i, NormalDistribution[a, b], "AndersonDarling"], {i, data}];ListLinePlot[Table[{sz, Probability[x > sz, xℋs]//N}, {sz, Range[0.001, .25, .01]}], AxesLabel -> {"Size", "Type II Error"}]有效检验的  值在
 下为 UniformDistribution[{0,1}]:
data = RandomVariate[NormalDistribution[], {1000, 25}];tests = {"AndersonDarling", "CramerVonMises", "KolmogorovSmirnov", "Kuiper"};p = Table[DistributionFitTest[i, NormalDistribution[], tests], {i, data}]//Transpose;Table[Histogram[p[[i]], Automatic, "ProbabilityDensity", PlotLabel -> tests[[i]]], {i, 4}]TableForm[Table[{tests[[i]], Round[DistributionFitTest[p[[i]], UniformDistribution[{0, 1}], "KolmogorovSmirnov"], .001]}, {i, 4}]]
data = RandomVariate[CauchyDistribution[0, 1], {1000, 25}];tests = {"AndersonDarling", "CramerVonMises", "JarqueBeraALM", "KolmogorovSmirnov", "Kuiper", "PearsonChiSquare", "ShapiroWilk", "WatsonUSquare"};p = Table[DistributionFitTest[i, Automatic, tests], {i, data}]//Transpose;
N[Table[{tests[[i]], Probability[x ≤ 0.05, xp[[i]]]}, {i, Length[tests]}]]//TableFormdata = RandomVariate[CauchyDistribution[0, 1], {500, 10}];tests = {"AndersonDarling", "CramerVonMises", "JarqueBeraALM", "KolmogorovSmirnov", "Kuiper", "PearsonChiSquare", "ShapiroWilk", "WatsonUSquare"};p = Table[DistributionFitTest[i, Automatic, tests], {i, data}]//Transpose;N[Table[{tests[[i]], Probability[x ≤ 0.05, xp[[i]]]}, {i, Length[tests]}]]//TableFormdata = RandomVariate[NormalDistribution[1, 1], {500, 25}];tests = {"AndersonDarling", "CramerVonMises", "KolmogorovSmirnov", "Kuiper", "PearsonChiSquare", "WatsonUSquare"};p = Table[DistributionFitTest[i, NormalDistribution[0, σ], tests], {i, data}]//Transpose;N[Table[{tests[[i]], Probability[x ≤ 0.05, xp[[i]]]}, {i, Length[tests]}]]//TableFormdata = RandomVariate[NormalDistribution[1, 1], {500, 25}];tests = {"AndersonDarling", "CramerVonMises", "KolmogorovSmirnov", "Kuiper", "PearsonChiSquare", "WatsonUSquare"};p = Table[DistributionFitTest[i, NormalDistribution[μ, 2], tests], {i, data}]//Transpose;N[Table[{tests[[i]], Probability[x ≤ 0.05, xp[[i]]]}, {i, Length[tests]}]]//TableForm
data1 = RandomVariate[StudentTDistribution[2], {500, 25}];
data2 = RandomVariate[StudentTDistribution[2], {500, 50}];
data3 = RandomVariate[StudentTDistribution[2], {500, 100}];p1 = Table[DistributionFitTest[i, Automatic, "PearsonChiSquare"], {i, data1}];
p2 = Table[DistributionFitTest[i, Automatic, "PearsonChiSquare"], {i, data2}];
p3 = Table[DistributionFitTest[i, Automatic, "PearsonChiSquare"], {i, data3}];{Probability[x ≤ 0.05, xp1], Probability[x ≤ 0.05, xp2], Probability[x ≤ 0.05, xp3]}//Ndata = RandomVariate[StudentTDistribution[2], {500, 100}];tests = {"AndersonDarling", "CramerVonMises", "JarqueBeraALM", "KolmogorovSmirnov", "Kuiper", "PearsonChiSquare", "ShapiroWilk", "WatsonUSquare"};p = Table[DistributionFitTest[i, NormalDistribution[a, b], tests], {i, data}]//Transpose;Jarque–Bera ALM 与 Shapiro–Wilk 检验对于小样本是最有效的:
N[Table[{tests[[i]], Probability[x ≤ 0.05, xp[[i]]]}, {i, Length[tests]}]]//TableFormdata = RandomVariate[NormalDistribution[], 100];ℋ1 = DistributionFitTest[data, NormalDistribution[1, 10], "ShapiroWilk"]ℋ2 = DistributionFitTest[data, NormalDistribution[10, 1], "ShapiroWilk"]检验方法不同,所检测的分布性质也不同. 基于某一个检验的结论并不总与其它检验所得到的结论一致:
data = RandomVariate[StudentTDistribution[3], {100, 50}];tests = {"Kuiper", "CramerVonMises", "KolmogorovSmirnov", "PearsonChiSquare"};pvs = Table[(DistributionFitTest[#1, Automatic, i]&) /@ data, {i, tests}];α = 0.2;conclusions[α_] := Show[Graphics[{Opacity[.5], Lighter[Purple], Rectangle[{0, 0}, {α, α}]}], Graphics[{Opacity[.5], Orange, Rectangle[{α, α}, {1, 1}]}], Graphics[{Opacity[.1], Gray, Rectangle[{0, α}, {α, 1}]}], Graphics[{Opacity[.1], Gray, Rectangle[{α, 0}, {1, α}]}]];绿色区域表示两种检验均得到正确结论. 当两种检验均产生第二类误差时,点落到红色区域. 灰色区域表示两种检验的结论不一致.
MapThread[Show[conclusions[α], ListPlot[Transpose[{pvs[[#1]], pvs[[#2]]}], AspectRatio -> 1], Frame -> True, FrameLabel -> {tests[[#1]], tests[[#2]]}]&, {{1, 1, 1, 2, 2, 3}, {2, 3, 4, 3, 4, 4}}]data = RandomVariate[NormalDistribution[], {1000, 35}];ℋ1 = Table[DistributionFitTest[i, NormalDistribution[μ, σ], "TestData"], {i, data}]//Transpose;

{Histogram[ℋ1[[1]], Automatic, "PDF", PlotLabel -> "Test Statistics"], Histogram[ℋ1[[2]], Automatic, "PDF", PlotLabel -> "P-Values"]}ℋ2 = Table[DistributionFitTest[i, EstimatedDistribution[i, NormalDistribution[μ, σ]], "TestData"], {i, data}]//Transpose;
{Histogram[ℋ2[[1]], Automatic, "PDF", PlotLabel -> "Test Statistics"], Histogram[ℋ2[[2]], Automatic, "PDF", PlotLabel -> "P-Values"]}分布拟合检验仅当输入为 TimeSeries 时适用于值:
ts = TemporalData[TimeSeries, {{{1.224578634529677, 0.47929635789978015, 0.6572781300178168,
    0.21496048742669355, 0.7299608014554928, -0.2495111111278263, -1.3286551762002712,
    0.552725018274874, 0.19272112205837066, 1.1809144012420882, -1.1671 ... 40938613662046, 1.052394590214582, 0.9345044123980388, 0.38537803109557855,
    -0.48660931166089394, -0.71203560340161}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];DistributionFitTest[ts, Automatic, {"TestDataTable", All}]DistributionFitTest[ts["Values"], Automatic, {"TestDataTable", All}]%% == %可能存在的问题 (5)

data = RandomVariate[ArcSinDistribution[{-1, 4}], 10];ℋ = DistributionFitTest[data, ArcSinDistribution[{a, b}], "AndersonDarling"]

DistributionFitTest[data, ArcSinDistribution[{a, b}], "AndersonDarling", Method -> "MonteCarlo"]ℋ2 = DistributionFitTest[RandomVariate[NormalDistribution[], 10], NormalDistribution[a, b], "AndersonDarling"]Jarque–Bera ALM 检验要求样本数至少为 10 以得到有效  值:
data = RandomVariate[NormalDistribution[], 5];DistributionFitTest[data, Automatic, "JarqueBeraALM"]

DistributionFitTest[data, Automatic, "JarqueBeraALM", Method -> "MonteCarlo"]
柯尔莫哥洛夫–斯米尔诺夫检验与 Kuiper 检验认为数据中不能存在任何关联:
data = {1., 2., 1.5, 2., 1.75, 2.5, 3.};DistributionFitTest[data, Automatic, {"TestDataTable", {"KolmogorovSmirnov", "Kuiper"}}]
Jarque–Bera ALM 检验与 Shapiro–Wilk 检验仅对正态性的检验有效:
data = RandomVariate[BetaDistribution[1, 2], 10];DistributionFitTest[data, BetaDistribution[a, b], {"TestDataTable", {"JarqueBeraALM", "ShapiroWilk"}}]
data = RandomVariate[𝒹 = DiscreteUniformDistribution[{1, 10}], 100];ℋ = DistributionFitTest[data, 𝒹, "HypothesisTestData"];ℋ["TestDataTable", {"CramerVonMises", "AndersonDarling", "KolmogorovSmirnov", "Kuiper", "WatsonUSquare"}]


ℋ["TestDataTable", "PearsonChiSquare"]巧妙范例 (1)
data = RandomVariate[𝒹 = NormalDistribution[], {5000, 50}];ℋ = DistributionFitTest[#, 𝒹, "HypothesisTestData"]& /@ data;T = Table[h["TestStatistic", i], {h, ℋ}, {i, tests = {"AndersonDarling", "CramerVonMises", "Kuiper", "KolmogorovSmirnov", "PearsonChiSquare", "WatsonUSquare"}}]//Transpose;Table[SmoothHistogram[T[[i]], PlotLabel -> tests[[i]], Filling -> Axis], {i, 6}]文本
Wolfram Research (2010),DistributionFitTest,Wolfram 语言函数,https://reference.wolfram.com/language/ref/DistributionFitTest.html (更新于 2015 年).
CMS
Wolfram 语言. 2010. "DistributionFitTest." Wolfram 语言与系统参考资料中心. Wolfram Research. 最新版本 2015. https://reference.wolfram.com/language/ref/DistributionFitTest.html.
APA
Wolfram 语言. (2010). DistributionFitTest. Wolfram 语言与系统参考资料中心. 追溯自 https://reference.wolfram.com/language/ref/DistributionFitTest.html 年