

FindDistribution
FindDistribution[data]
data の分布にフィットする単純な関数形式を求める.
FindDistribution[data,n]
最良の分布を n 個まで求める.
FindDistribution[data,n,prop]
特性 prop と関連する最良の分布を n 個まで返す.
FindDistribution[data,n,{prop1,prop2,…}]
特性 prop1,prop2等に関連する最良の分布を n 個まで返す.
詳細とオプション
- データは,一変量分布からの可能な結果のリストでなければならない.
- FindDistribution[data,n,All]は,可能なすべての特性を持つDatasetオブジェクトを作成する.
- サポートされる特性
-
"BIC" ベイズ情報量基準 "AIC" 赤池情報量基準 "HQIC" Hannan–Quinn情報量基準 "Score" 内部スコア "Complexity" 分布の複雑さ "LogLikelihood" LogLikelihood 値 "PearsonChiSquare" PearsonChiSquareTest p 値 "CramerVonMises" CramerVonMisesTest p 値 All 上記の特性すべて - 使用可能なオプション
-
MaxItems Infinity 混合分布における分布の最高数 PerformanceGoal Automatic パフォーマンスのどの面について最適化するか RandomSeeding Automatic どのような擬似乱数生成器のシードを内部的に使うべきか TargetFunctions Automatic 考慮する分布タイプ - PerformanceGoalの可能な設定
-
"Speed" 分布を求めるために使用する時間を最短にする "Quality" よりよい分布を求めようとする - TargetFunctionsの可能な設定
-
Automatic 自動選択された分布 All すべての組込み分布 "Continuous" すべての連続分布 "Discrete" すべての離散分布 {dist1,  ,
 }
分布 disti { 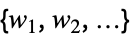 {dist1,
 ,
 }}
重み wiを使った分布 disti - RandomSeedingの可能な設定
-
Automatic 関数が呼び出されるたびに自動的にシードを変える Inherited 外部シードの乱数を使う seed 明示的な整数または文字列をシードとして使う - TargetFunctionsで使用可能な連続分布には,BetaDistribution,CauchyDistribution,ChiDistribution,ChiSquareDistribution,ExponentialDistribution,ExtremeValueDistribution,FrechetDistribution,GammaDistribution,GumbelDistribution,HalfNormalDistribution,InverseGaussianDistribution,LaplaceDistribution,LevyDistribution,LogisticDistribution,LogNormalDistribution,MaxwellDistribution,NormalDistribution,ParetoDistribution,RayleighDistribution,StudentTDistribution,UniformDistribution,WeibullDistribution,HistogramDistributionがある.
- TargetFunctionsで使用可能な離散分布には,BenfordDistribution,BinomialDistribution,BorelTannerDistribution,DiscreteUniformDistribution,GeometricDistribution,LogSeriesDistribution,NegativeBinomialDistribution,PascalDistribution,PoissonDistribution,WaringYuleDistribution,ZipfDistribution,HistogramDistribution,EmpiricalDistributionがある.
- 内部情報量基準には,ベイズ情報基準をTargetFunctionsの確率とともに使う.
例題
すべて開く すべて閉じる例 (2)
RandomInteger[10, 100]FindDistribution[%]𝒟 = ExponentialDistribution[1];
data = RandomVariate[𝒟, 1000];estimated𝒟 = FindDistribution[data]Plot[{PDF[𝒟, x], PDF[estimated𝒟, x]}, {x, 0, 10}, PlotLegends -> {"𝒟", "e𝒟"}]FindDistribution[data, 3]FindDistribution[data, 3, {"BIC", "AIC"}]スコープ (3)
𝒟 = MixtureDistribution[{1, 1}, {ExponentialDistribution[1], NormalDistribution[5, 0.8]}];data = RandomVariate[𝒟, 1000];e𝒟 = FindDistribution[data]Plot[{PDF[𝒟, x], PDF[e𝒟, x]}, {x, -8, 10}, PlotLegends -> {"𝒟", "e𝒟"}, PlotRange -> All]𝒟 = WeibullDistribution[1, 2];data = RandomVariate[𝒟, 1000];デフォルトで,FindDistributionは単純な分布を返す:
e𝒟 = FindDistribution[data]e𝒟 = FindDistribution[data, TargetFunctions -> {WeibullDistribution}]𝒟 = ExponentialDistribution[1];
data = RandomVariate[𝒟, 1000];上位2分布についての全特性を含むDatasetを生成する:
report = FindDistribution[data, 2, All]オプション (5)
TargetFunction (3)
𝒟 = MixtureDistribution[{1, 1}, {ExponentialDistribution[1], NormalDistribution[5, 0.8]}];data = RandomVariate[𝒟, 1000];e𝒟 = FindDistribution[data, TargetFunctions -> {NormalDistribution, GammaDistribution}]Plot[{PDF[𝒟, x], PDF[e𝒟, x]}, {x, -8, 10}, PlotLegends -> {"𝒟", "e𝒟"}, PlotRange -> All]waiting = ExampleData[{"Statistics", "OldFaithful"}][[All, 2]];e𝒟1 = FindDistribution[waiting]e𝒟2 = FindDistribution[waiting, TargetFunctions -> "Continuous"]連続的であるとして扱われた場合のデータの分布をGammaDistributionを使って推定する:
e𝒟3 = FindDistribution[waiting, TargetFunctions -> {GammaDistribution}]legend = SwatchLegend[{Red, ColorData[97, 1], ColorData[97, 2]}, {"e𝒟1", "e𝒟2", "e𝒟3"}];Show[Histogram[waiting, 20, "ProbabilityDensity"],
DiscretePlot[{PDF[e𝒟1, x]}, {x, 0, 100}, PlotStyle -> {PointSize[.02], Red}],
Plot[{PDF[e𝒟2, x], PDF[e𝒟3, x]}, {x, 0, 100}, PlotLegends -> legend]]特定の分布についての母数を,その分布についての事前分布を仮定して推定する:
magnitudes = Select[ExampleData[{"Statistics", "USEarthquakes"}], #[[1]] ≥ 1935&][[All, 7]];1935年から1989年までの米国の地震のマグニチュードには2つの峰がある:
h = Histogram[magnitudes, 20, "ProbabilityDensity"]TargetFunctionsを使わずに最良フィットを推定する:
Subscript[``e𝒟``, 1] = FindDistribution[magnitudes]Subscript[``e𝒟``, 2 ] = FindDistribution[magnitudes, TargetFunctions -> {{10, 2} -> {CauchyDistribution, GammaDistribution}}]Show[h, Plot[{PDF[Subscript[``e𝒟``, 1], x], PDF[Subscript[``e𝒟``, 2 ], x]}, {x, 0, 10}, PlotStyle -> Thick, PlotRange -> All]]PerformanceGoal (1)
𝒟 = MixtureDistribution[{1, 2}, {ChiDistribution[0.6], GammaDistribution[20, 1]}]data = RandomVariate[𝒟, 10000];ビッグデータの集合について最良フィットを推定し,PerformanceGoalのさまざまな設定についてAbsoluteTimingを比較する:
AbsoluteTiming[e𝒟1 = FindDistribution[data, PerformanceGoal -> "Speed"]]AbsoluteTiming[e𝒟2 = FindDistribution[data, PerformanceGoal -> "Quality"]]解のLogLikelihoodを比較する:
LogLikelihood[#, data]& /@ {e𝒟1, e𝒟2}RandomSeeding (1)
𝒟 = MixtureDistribution[{1, 2}, {NormalDistribution[-6, 1], GammaDistribution[20, 1]}]data = RandomVariate[𝒟, 1000];FindDistributionの異なるラウンドを比較し,どのように違うかを見る:
Table[FindDistribution[data], 3]オプションRandomSeedingを使って結果が異ならないようにする:
Table[FindDistribution[data, RandomSeeding -> 1], 3]アプリケーション (5)
特定の文字で始まる単語の長さ (1)
letters = {"a", "e", "i", "o", "u", "y"};worddata = Table[StringLength /@ DictionaryLookup[l ~~ ___], {l, letters}];e𝒟 = Table[FindDistribution[i, MaxItems -> 1], {i, worddata}]Partition[Table[Show[Histogram[worddata[[i]], {Range[25] - 1 / 2}, "ProbabilityDensity", PlotLabel -> letters[[i]]], DiscretePlot[PDF[e𝒟[[i]], x], {x, 0, 25}, PlotRange -> All, PlotStyle -> PointSize[.025]], ImageSize -> Small], {i, Length[letters]}], 3]//Gridテキスト頻度 (1)
text = ExampleData[{"Text", "DeclarationOfIndependence"}, "Words"];wordCount = Tally[text][[All, 2]];e𝒟 = FindDistribution[wordCount, MaxItems -> 1]もとのデータのヒストグラムと推定分布の確率密度関数を比較する:
Show[Histogram[wordCount, {0.5, 9.5, 1}, "ProbabilityDensity"], DiscretePlot[PDF[e𝒟, x], {x, 1, 10}, PlotStyle -> PointSize[Medium], PlotRange -> All]]デンマークにおけるメラノーマ (1)
melanomaAge = ExampleData[{"Statistics", "DenmarkMelanoma"}][[All, 4]];e𝒟 = FindDistribution[melanomaAge]
Show[Histogram[melanomaAge, {4, 95, 4}, "ProbabilityDensity"], Plot[PDF[e𝒟, x], {x, 4, 95}, PlotStyle -> Thick, PlotRange -> All]]AIDSの感染時間 (1)
aids = ExampleData[{"Statistics", "TimeToAIDS"}][[All, 1]];e𝒟 = FindDistribution[aids]Show[Histogram[aids, {0, 8, 0.65}, "ProbabilityDensity"], Plot[PDF[e𝒟, x], {x, 0, 8}, PlotStyle -> Thick, PlotRange -> All]]カテーテルを交換してから腎感染までの時間 (1)
KidneyInfection = ExampleData[{"Statistics", "KidneyInfection"}][[All, 1]];e𝒟 = FindDistribution[KidneyInfection]Show[Histogram[KidneyInfection, {0, 28, 2}, "ProbabilityDensity"], Plot[PDF[e𝒟, x], {x, 0, 28}, PlotStyle -> Thick, PlotRange -> All]]特性と関係 (1)
デフォルトで,FindDistributionParametersは最大尤度を使って固定分布の分布母数を推定する.FindDistributionはベイズ情報量基準と事前確率と組み合せる完全なベイズ的アプローチを使って最適な分布と最適な母数の両方を求める.
StudentTDistributionからサンプルを取ってデータを生成する:
SeedRandom[5]
data = RandomVariate[StudentTDistribution[1, 1, 4], 800];
Histogram[data, {-10, 10, Automatic}, "ProbabilityDensity"]FindDistributionを使ってこのデータに最もフィットする分布を推定する:
dist1 = FindDistribution[data, RandomSeeding -> 1]FindDistributionParametersを使い,StudentTDistributionを仮定して最適な母数を推定する:
distribution = StudentTDistribution[α, β, ν];
estimatedParameters = FindDistributionParameters[data, distribution];
dist2 = distribution /. estimatedParametersStudentTDistributionは対数尤度を最小にするが,LogisticDistributionはこれに比べて事前確率が高く複雑さは低い.
対応するLogLikelihoodと比較する:
LogLikelihood[#, data]& /@ {dist1, dist2}FindDistributionParametersとほぼ同じ母数を求めないなら,オプションTargetFunctionsを使うとよい:
dist3 = FindDistribution[data, TargetFunctions -> {StudentTDistribution}]テキスト
Wolfram Research (2015), FindDistribution, Wolfram言語関数, https://reference.wolfram.com/language/ref/FindDistribution.html (2017年に更新).
CMS
Wolfram Language. 2015. "FindDistribution." Wolfram Language & System Documentation Center. Wolfram Research. Last Modified 2017. https://reference.wolfram.com/language/ref/FindDistribution.html.
APA
Wolfram Language. (2015). FindDistribution. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/FindDistribution.html